浏览器本地存储:Cookie、Web Storage 与 IndexedDB
核心要点
- 移动端 WebApp 能做到「点开就用、关掉就走」,体验逼近原生 App,靠的是两条腿:HTTP 缓存(见 浏览器缓存机制)和本地存储。本文讲后者。
- Cookie 生来是为了让无状态的 HTTP 「记住」客户端,并不是为存数据设计的。它以键值对形式保存,单条上限约 4KB,而且同一域名下的每个请求都会自动带上它,连图片、CSS 也不例外。把它当仓库用,会白白拖慢每一个请求。
- Web Storage 是 HTML5 专门给浏览器端存数据准备的,分
localStorage和sessionStorage:- 二者 API 完全相同(
setItem/getItem/removeItem/clear),容量一般 5MB 左右(不同浏览器 5–10MB),数据只留在浏览器,不随请求发给服务器。 - 区别在生命周期和作用域:
localStorage不主动删就一直在,同源页面共享;sessionStorage跟着标签页走,标签页关闭即清空,同源的两个标签页之间也不共享。 - 局限:只能存字符串、API 是同步的,只适合少量、结构简单的数据。
- 二者 API 完全相同(
- 典型用法:
localStorage存长期不变的东西(例如 Base64 图片、版本稳定的静态资源、用户偏好);sessionStorage存只对本次会话有意义的东西(例如浏览足迹、表单草稿)。 - IndexedDB 是浏览器里的非关系型数据库:能建多个库,库里建多个 object store(相当于表),每个 store 存多条记录;支持对象、二进制数据、索引和事务,容量以百 MB 甚至 GB 计。数据量大、结构复杂、Web Storage 搞不定的场景交给它。
- 原生 IndexedDB 是事件回调式 API,实际项目多用
idb、Dexie.js、localForage封装;离线能力则用 Service Worker + Cache API(可配合 Workbox)和 IndexedDB 一起构成 PWA。
Cookie:本职是记住「你是谁」
为什么会有 Cookie
HTTP 是无状态协议。服务器收到请求、回一个响应,这次交互就算结束,它不会替客户端留下任何记录。用户刚登录完,下一个请求过来,服务器分不清这还是不是刚才那个人。
Cookie 就是为解决这个问题出现的。它是浏览器为某个站点保存的一小段文本:服务器通过响应头 Set-Cookie 让浏览器记下几项数据,之后浏览器向这个站点发请求时,会把它们放进请求头 Cookie 里送回去。服务器读到这些值,就能认出客户端、恢复它的状态(登录态、购物车数量等)。
HTTP/1.1 200 OK
Set-Cookie: sid=f3a9c1e07b; Path=/; HttpOnly; Secure; SameSite=Lax

GET /api/cart HTTP/1.1
Host: shop.example
Cookie: sid=f3a9c1e07b; lang=zh-CN
在 Chrome 开发者工具的 Application 面板里展开 Cookies,就能看到当前站点保存的全部 Cookie。可以看出它是一条条键值对,每条再附带一组属性:
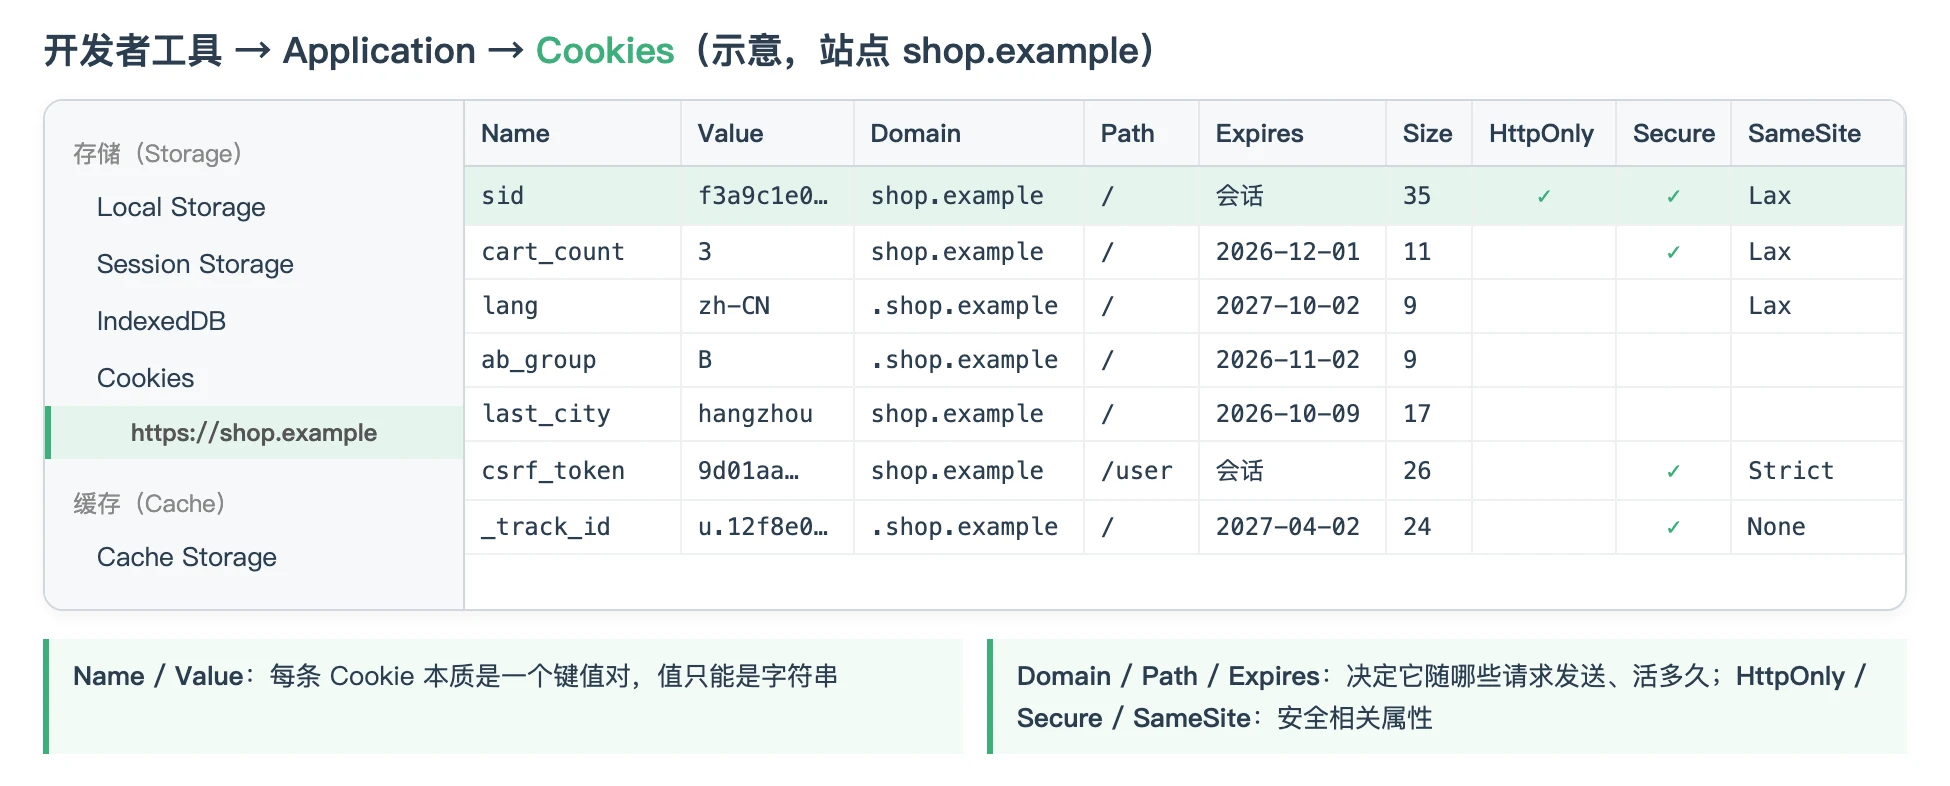
| 属性 | 作用 |
|---|---|
Domain / Path | 决定哪些请求会带上这条 Cookie |
Expires / Max-Age | 过期时间;都不设就是会话 Cookie,浏览器关闭后失效 |
HttpOnly | JS 读不到(document.cookie 里没有它),降低被 XSS 偷走的风险 |
Secure | 只在 HTTPS 下发送 |
SameSite | Strict / Lax / None,限制跨站请求是否携带,用来防 CSRF;Chrome/Edge 等 Chromium 浏览器缺省按 Lax 处理(Firefox、Safari 目前没有跟进这个默认值,所以最好显式写明),设成 None 时必须同时带 Secure |
把 Cookie 当存储用,代价在哪
第一,装不下。 单条 Cookie(名字加值)的上限大约是 4KB,超出的部分会被浏览器丢弃或整条拒收。每个域名能存的条数也有限(通常几十到一百多条)。它只适合放标识符这类很短的信息。
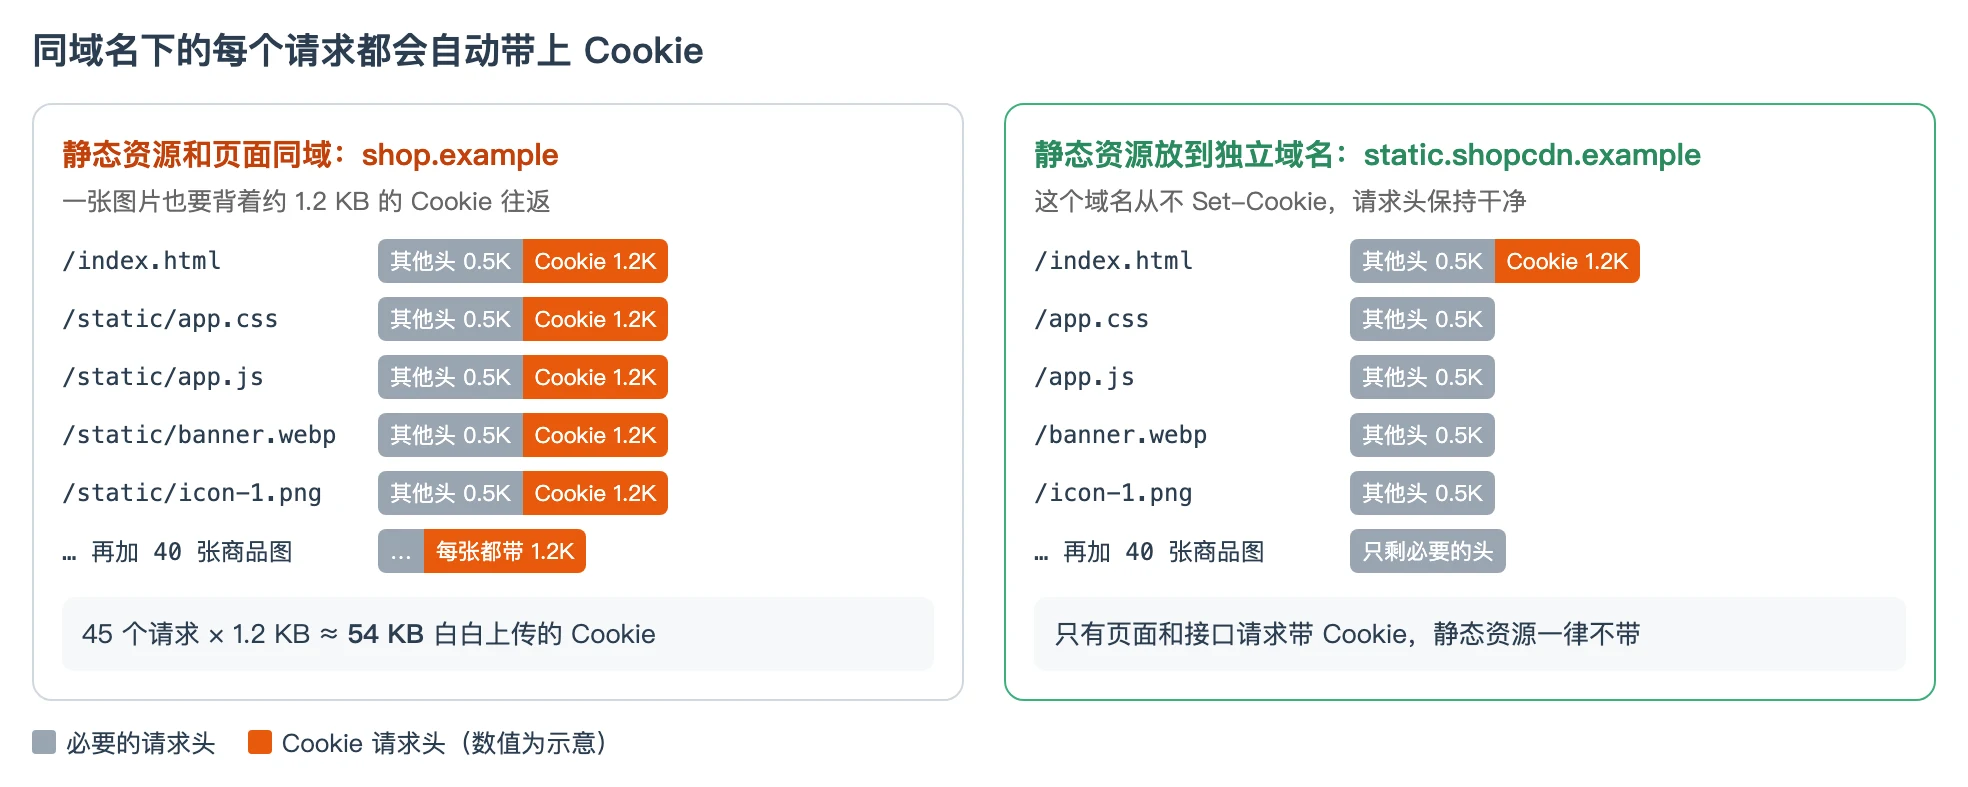
第二,处处跟着请求跑。 Cookie 绑定在域名上。服务端用 Set-Cookie 下发时,如果不写 Domain,它只属于当前这台主机;写了 Domain,这个域名及其子域名都会共享它:
Set-Cookie: lang=zh-CN; Domain=shop.example; Path=/
麻烦在于:只要请求的目标域名、路径匹配,浏览器就会自动附上 Cookie,不管这个请求需不需要。页面上几十张商品图、几个 CSS 和 JS 文件,每个请求头里都要捎带同样一串 Cookie,服务器拿到后根本不看。单条请求多出 1KB 看起来不起眼,乘上请求数量,再算上移动网络里上行带宽本就比下行窄,累积起来就是实打实的延迟和流量。
常见的优化手段:
- 静态资源放到独立的 cookie-free 域名(通常就是 CDN 域名),且不在主站上把 Cookie 的
Domain设成能覆盖它的父域名。 - 精简 Cookie:只放会话 ID 这类必要的标识,其余数据挪到服务端或下文的 Web Storage。
- 合理设置
Path,只对需要的路径生效。 - HTTP/2、HTTP/3 的头部压缩(HPACK / QPACK)能缓解重复头部的开销,但第一次发送和变化的 Cookie 照样要传,不能替代上面几条。
早年的前端没有别的本地存储可用,Cookie 被迫一身多用:除了会话标识,各种偏好、统计标记、临时数据都往里塞。不到 4KB 的空间承担了远超设计的职责,同时还让每个请求变胖。为了把「存数据」从 Cookie 身上剥离出来,浏览器推出了 Web Storage。
Web Storage:localStorage 与 sessionStorage
Web Storage 是 HTML5 为浏览器端存储专门设计的机制,包含 localStorage 和 sessionStorage 两个对象。它们的用法一模一样,差异只在「数据活多久」「谁能看到」。
两者的区别
| localStorage | sessionStorage | |
|---|---|---|
| 生命周期 | 持久保存,不手动删除(代码删除或用户清除站点数据)就一直在 | 跟随标签页:页面刷新、在同一标签页内跳转都还在,标签页关闭就清空 |
| 作用域 | 同源(协议 + 域名 + 端口)的所有页面、所有标签页共享 | 同源也不够,还必须是同一个标签页;同一网址开在两个标签页里,各有一份 |
几个容易被问到的细节:
- 三种存储(Cookie、localStorage、sessionStorage)都受同源策略约束,但 Cookie 的「同源」是按域名和路径算的,不区分端口,并且可以通过
Domain放宽到父域名,严格程度和 Web Storage 不同。 - 用「复制标签页」或在页面里通过
window.open打开同源新窗口时,新页面会得到一份sessionStorage的拷贝,此后两边各改各的,互不影响。 - 「永不过期」只是规范层面的说法。存储空间吃紧时浏览器可能回收数据,Safari 的 ITP 策略还会在用户 7 天没有与某站点交互后,清掉该站点脚本写入的存储。真正不能丢的数据要放服务端,或者调用
navigator.storage.persist()申请持久化。
共同特点
- 容量大得多:大多数浏览器给每个源 5MB 左右(不同浏览器在 5–10MB 之间),是 Cookie 的上千倍。
- 只存在浏览器端:不会自动附带到任何请求里,服务端看不到,也就没有 Cookie 那样的带宽开销。
- 只能存字符串:数据和 Cookie 一样是文本键值对,非字符串的值会被强制转成字符串。
- 同步 API:读写会阻塞主线程。存小数据无感,频繁读写大块内容(比如几百 KB 的字符串)就可能造成卡顿,Web Worker 和 Service Worker 里也用不了它。
API 速览
两个对象的 API 完全相同,以 localStorage 为例:
localStorage.setItem('theme', 'dark')           // 写入
localStorage.getItem('theme')                   // 读取 → 'dark'
localStorage.getItem('fontSize')                // 不存在的键 → null
localStorage.removeItem('theme')                // 删除单个键
localStorage.clear()                            // 清空当前源下的全部数据

localStorage.length                             // 键的数量
localStorage.key(0)                             // 按序号取键名
把数字或对象直接存进去,取出来的都是字符串:
localStorage.setItem('fontSize', 16)
typeof localStorage.getItem('fontSize')         // 'string'

localStorage.setItem('cart', { sku: 'A12', qty: 2 })
localStorage.getItem('cart')                    // '[object Object]',数据已经丢了
所以实际项目里通常会包一层,用 JSON 序列化,顺便处理过期时间和写满时的异常:
const store = {
  set(key, value, ttlMs) {
    const record = { value, expireAt: ttlMs ? Date.now() + ttlMs : null }
    try {
      localStorage.setItem(key, JSON.stringify(record))
      return true
    } catch (err) {
      // 超出配额时浏览器抛 QuotaExceededError
      console.warn('写入失败', err.name)
      return false
    }
  },
  get(key, fallback = null) {
    const raw = localStorage.getItem(key)
    if (raw === null) return fallback
    try {
      const { value, expireAt } = JSON.parse(raw)
      if (expireAt !== null && Date.now() > expireAt) {
        localStorage.removeItem(key)
        return fallback
      }
      return value
    } catch {
      return fallback // 不是本封装写入的数据
    }
  },
}

store.set('cart', { sku: 'A12', qty: 2 })
store.set('coupon', 'NEW10', 50)                // 50 毫秒后过期
store.get('cart')                               // { sku: 'A12', qty: 2 }
setTimeout(() => store.get('coupon', '已过期'), 80) // → '已过期'
另外,同源的其他标签页修改了 localStorage 时,当前页面会收到 storage 事件,可以用它做多标签页之间的简单同步(例如一处退出登录,其他标签页跟着跳转):
window.addEventListener('storage', (e) => {
  if (e.key === 'token' && e.newValue === null) location.href = '/login'
})
两种 Web Storage 各自适合存什么
localStorage:长期稳定的数据
localStorage 对数据类型以外几乎没有限制,凡是 Cookie 装不下、又能用简单键值对表达的数据,都可以交给它。它最大的特点是持久,所以更适合存内容不常变化的东西。
一个经典例子:图片很多的电商页面,把常用的小图(图标、Logo、活动横幅)转成 Base64 字符串存进 localStorage,键用图片地址,下次进页面直接读出来赋给 <img> 的 src,省掉一批图片请求:
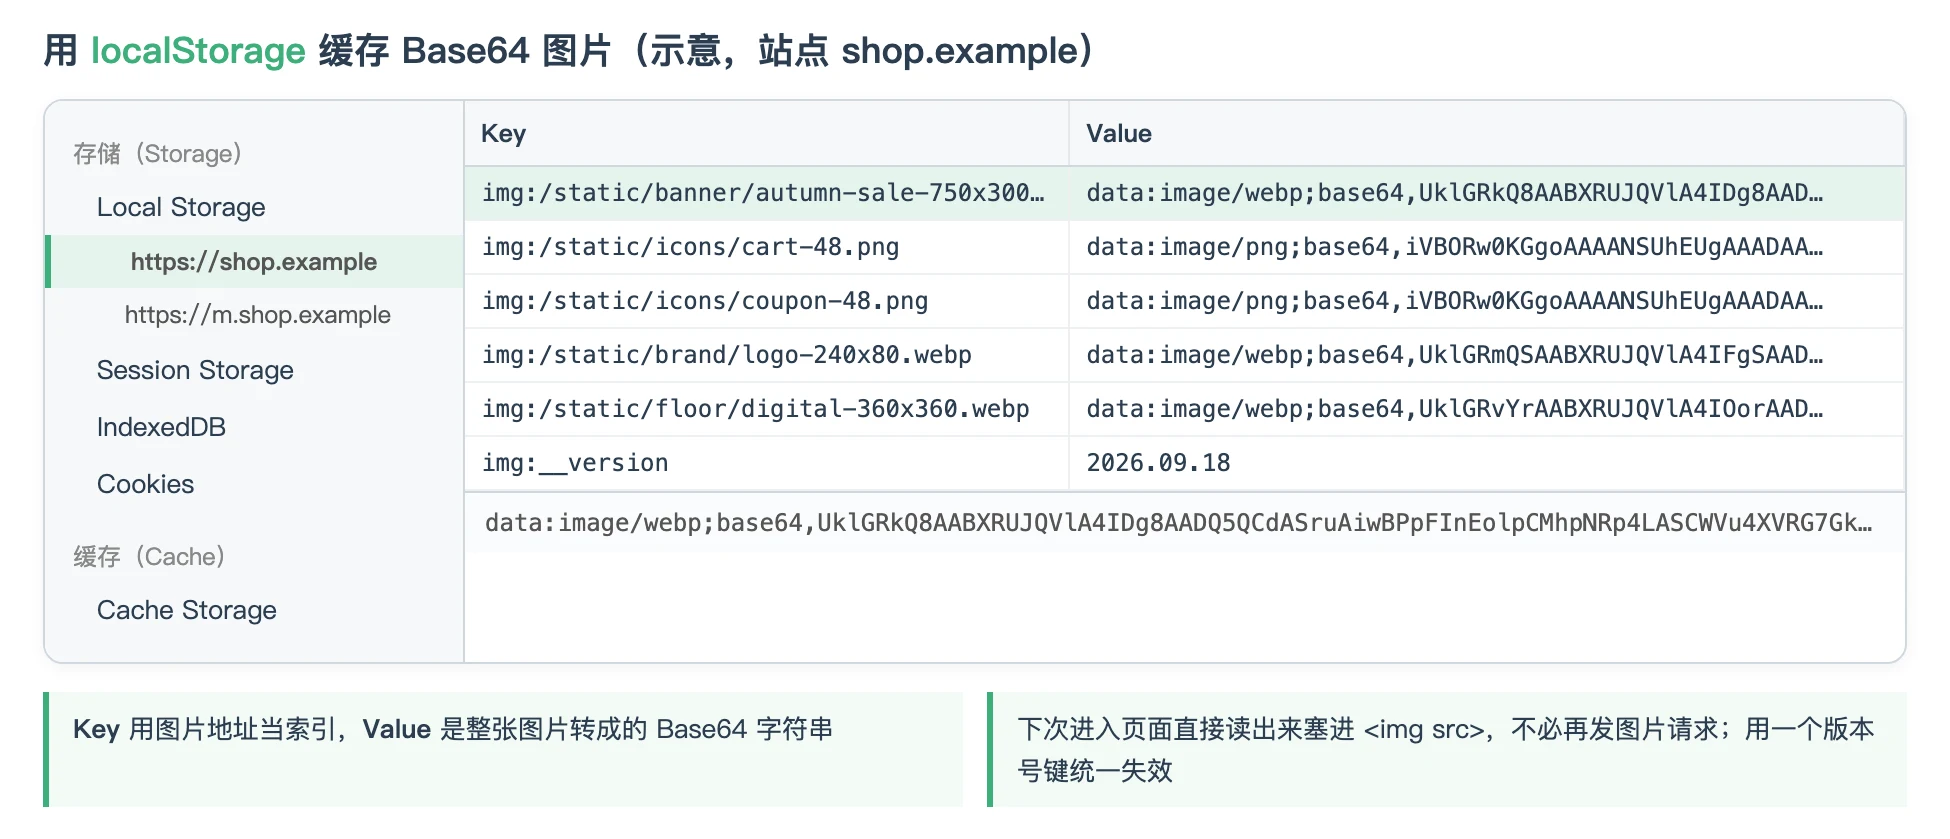
同样的思路也被用来缓存不常更新的 CSS、JS 文件:首次请求后把文件内容存进 localStorage,之后直接从本地取出插入页面,再用版本号判断是否需要更新。
现代做法提醒:这类「把资源塞进 localStorage」的技巧在 HTTP 缓存和 Service Worker 普及之前很流行,如今已不推荐。Base64 比原文件大约三分之一,同步读写大字符串会阻塞主线程,5MB 也很快用完。静态资源更好的选择是长期强缓存(
Cache-Control: max-age=31536000, immutable配合文件名带 hash),或者用 Service Worker 的 Cache API 做离线缓存。localStorage今天更常用来存用户偏好(主题、语言)、功能开关、不敏感的小块配置等。也不要把令牌等敏感信息放进去,任何能执行的脚本都读得到它。
sessionStorage:只属于这次会话的数据
sessionStorage 适合存生命周期和会话一致的数据:只在当前这次浏览中有用,开启新会话时本来就该重新生成或丢弃。
比如一个社区网站用它记录用户这次的浏览足迹:上一个页面的地址、信息流滚动到哪里,方便「返回」时恢复位置:
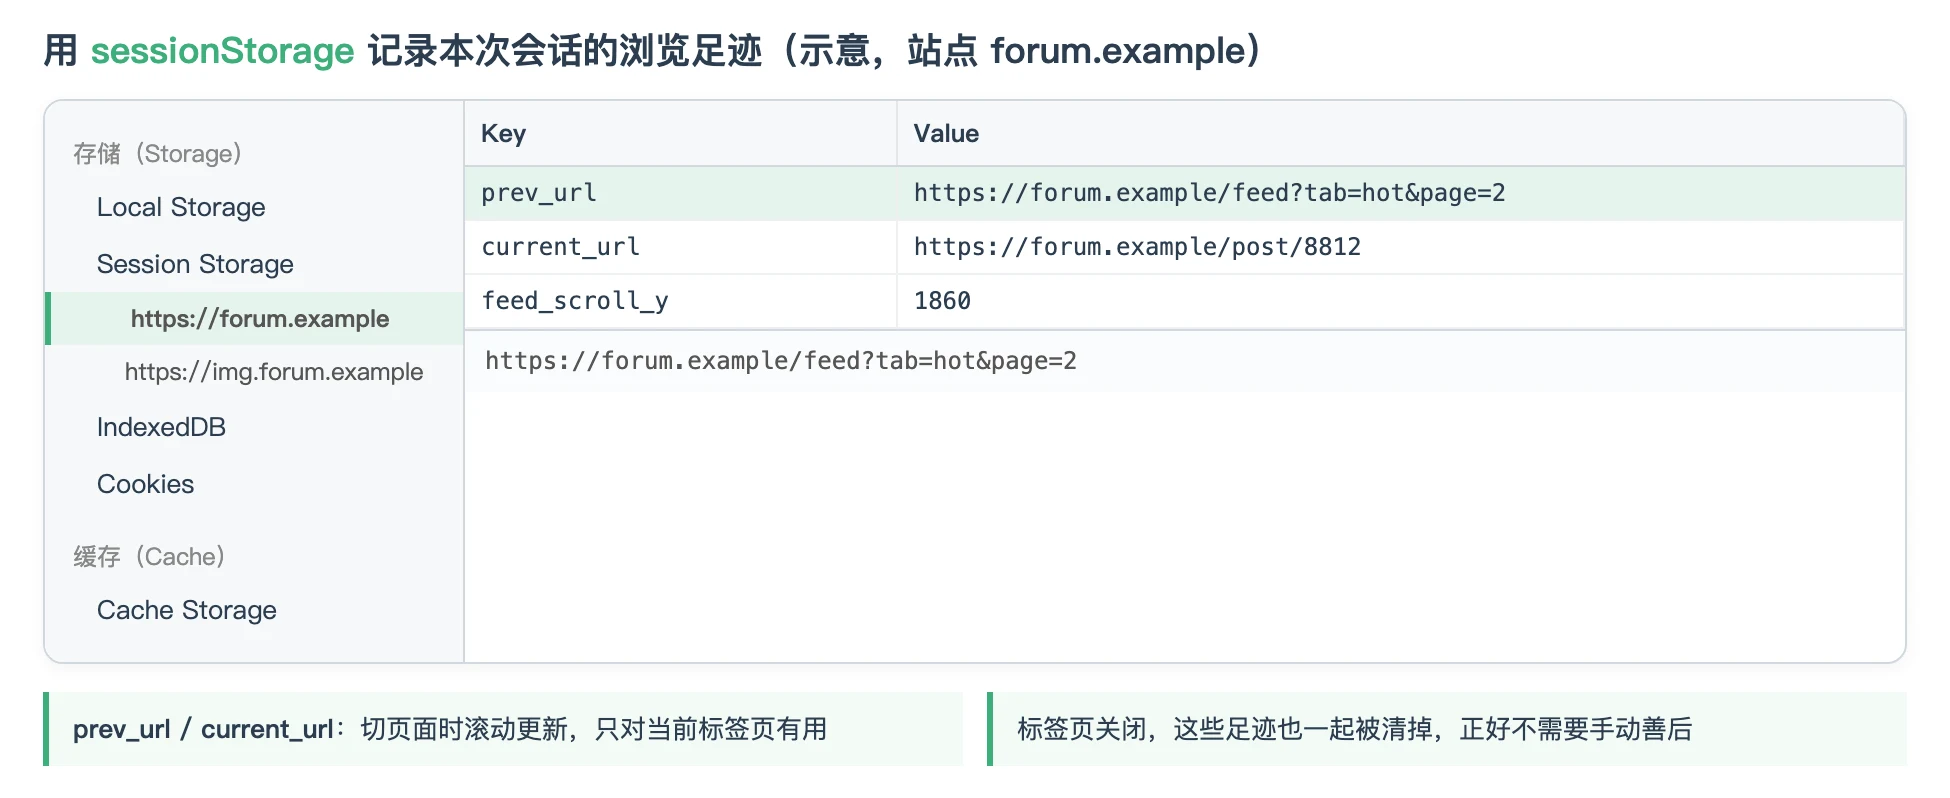
function rememberVisit(url) {
  const prev = sessionStorage.getItem('current_url')
  if (prev) sessionStorage.setItem('prev_url', prev)
  sessionStorage.setItem('current_url', url)
}

rememberVisit('/feed?tab=hot')
rememberVisit('/post/8812')
sessionStorage.getItem('prev_url')              // '/feed?tab=hot'
这些地址每切换一次页面就要更新,标签页一关就毫无价值,正好交给 sessionStorage 自动回收。类似的还有多步表单的草稿、一次性的筛选条件等。
Web Storage 的天花板
Web Storage 定义简单、用起来也简单,但正因为简单,它承担不了所有存储需求。它看似像一个对象,实际上连对象都存不了,只认字符串,每次存取结构化数据都要自己序列化和解析;它没有索引,不能按条件查询;同步 API 还让大数据量读写成为性能隐患。
归根结底,Web Storage 是对 Cookie 的扩展,定位是少量、简单的数据。面对大规模、结构复杂的数据,就要请出 IndexedDB。
IndexedDB:浏览器里的数据库
名称说明:标准名称是 IndexedDB,标题里的「IndexDB」是常见的误写,指的是同一个东西。
IndexedDB 是运行在浏览器里的非关系型数据库,和 Web Storage 不在一个量级:
- 容量大:不再是 5MB、10MB 的级别。早期常说「理论上没有上限,一般不小于 250MB」;现在各浏览器统一按磁盘空间分配配额,Chrome 允许单个源使用可用磁盘的很大比例(可达约 60%),Firefox、Safari 也在 GB 级别。可以用
navigator.storage.estimate()查询当前用量和配额。 - 能存的类型多:任何可被结构化克隆的值都行,包括普通对象、数组、
Date,以及Blob、File、ArrayBuffer等二进制数据,不用自己转字符串。 - 有数据库的能力:主键、索引、范围查询、游标、事务。
- 异步:读写不阻塞主线程,在 Web Worker、Service Worker 里也能用。
结构:库 → 表 → 记录
一个源下可以建多个数据库;每个数据库里可以建多个 object store(对应关系型数据库里的「表」);每个 store 里存多条记录,用主键定位,还可以额外建索引。这种层次足以容纳复杂的结构化数据。
一次完整的读写流程
IndexedDB 的详细教程很多,这里不展开所有 API,只按 MDN 推荐的基本步骤走一遍,建立直观印象。示例创建一个名为 notebook 的库,里面放一张 notes 表:
第 1 步:打开数据库。 open(库名, 版本号) 在库不存在时会直接新建,返回的是一个请求对象,结果通过事件拿到:
const openReq = window.indexedDB.open('notebook', 1)

openReq.onerror = () => console.error('打开数据库失败', openReq.error)
第 2 步:在 onupgradeneeded 里建 object store。 这个事件在库第一次创建、或版本号变大时触发,表和索引只能在这里创建或修改:
openReq.onupgradeneeded = (event) => {
  const db = event.target.result            // 此时 onsuccess 还没触发,要从事件里拿
  if (!db.objectStoreNames.contains('notes')) {
    const notes = db.createObjectStore('notes', { keyPath: 'noteId' })
    notes.createIndex('byTag', 'tag')        // 顺手建一个索引,方便按标签查
  }
}
keyPath: 'noteId' 表示用记录里的 noteId 字段当主键。
一个常见错误:
onupgradeneeded比onsuccess先触发。如果习惯在onsuccess里把数据库实例赋给外部变量,再在onupgradeneeded里用这个变量,拿到的是undefined。升级回调里一定要从event.target.result(或openReq.result)取实例。
第 3 步:开启事务,执行增删改查。 所有读写都必须放在事务里:先指定涉及哪些 store、只读还是读写,再从事务里取出 store 操作:
openReq.onsuccess = (event) => {
  const db = event.target.result
  const tx = db.transaction('notes', 'readwrite')
  const notes = tx.objectStore('notes')
  notes.put({ noteId: 101, tag: 'perf', text: '图片走 CDN 独立域名' })
  notes.put({ noteId: 102, tag: 'perf', text: '首屏关键 CSS 内联' })
  notes.put({ noteId: 103, tag: 'todo', cover: new Uint8Array([137, 80, 78, 71]) }) // 二进制也能直接存

  // 第 4 步写在这里
}
add 遇到主键已存在会报错,put 则是「有就覆盖、没有就新增」。
第 4 步:监听事件,确认操作结果。 事务里的操作全部成功后触发 complete,任何一步失败会触发 error 并整体回滚:
  tx.oncomplete = () => {
    console.log('写入完成')
    // 用索引按标签查询
    const req = db.transaction('notes', 'readonly')
      .objectStore('notes').index('byTag').getAll('perf')
    req.onsuccess = () => console.log(req.result.map((n) => n.text))
    // → [ '图片走 CDN 独立域名', '首屏关键 CSS 内联' ]
  }
  tx.onerror = () => console.error('事务失败', tx.error)
用 Promise 简化
原生 API 处处是 onsuccess / onerror,嵌套一深就难读。把每个请求包成 Promise,就能用 async/await 写:
// 把一次 IDBRequest 包成 Promise
const done = (req) =>
  new Promise((resolve, reject) => {
    req.onsuccess = () => resolve(req.result)
    req.onerror = () => reject(req.error)
  })

async function main() {
  const openReq = indexedDB.open('notebook', 1)
  openReq.onupgradeneeded = () =>
    openReq.result.createObjectStore('notes', { keyPath: 'noteId' })
  const db = await done(openReq)

  const store = db.transaction('notes', 'readwrite').objectStore('notes')
  await done(store.put({ noteId: 7, text: '用 Promise 包一层就顺手多了' }))
  const note = await done(db.transaction('notes').objectStore('notes').get(7))
  console.log(note.text)
}

main().catch(console.error)
生产环境一般直接用成熟的封装库:
| 库 | 特点 |
|---|---|
idb | 很薄的一层,把原生 API 换成 Promise,概念和原生一一对应 |
Dexie.js | 更完整的查询语法、版本迁移、响应式查询,适合数据较复杂的应用 |
localForage | 提供类似 localStorage 的 getItem / setItem Promise API,底层优先用 IndexedDB,不可用时自动降级 |
什么时候用 IndexedDB
从上面的流程能看出,IndexedDB 支持多库、多表、多记录,再加上索引和事务,完全能撑起结构复杂的数据。可以把它看作 localStorage 的升级:数据规模或复杂度超出 localStorage 的能力时,就该换成它。典型场景:
- 离线应用的业务数据(笔记、待办、草稿、消息记录),联网后再与服务端同步。
- 大量列表数据的本地缓存,配合索引做本地搜索和筛选。
- 图片、音频、文件等二进制内容的本地保存。
现代离线方案:IndexedDB + Service Worker
本地存储和缓存的组合,是 WebApp 体验能追上原生应用的关键。现在构建离线可用的 Web 应用,一般这样分工:
- Service Worker + Cache API:拦截网络请求,缓存 HTML、JS、CSS、图片等资源,断网时也能打开页面。手写缓存策略容易出错,常用 Google 的 Workbox 生成。
- IndexedDB:保存结构化的业务数据,Service Worker 和页面都能访问。
- 两者再加上 Web App Manifest,就构成了 PWA(Progressive Web App):可安装到桌面、可离线、可接收推送。
怎么选:一张表总结
| Cookie | localStorage | sessionStorage | IndexedDB | |
|---|---|---|---|---|
| 设计目的 | 维持会话状态 | 持久保存简单数据 | 保存会话级简单数据 | 浏览器端数据库 |
| 容量 | 单条约 4KB | 约 5MB(5–10MB) | 约 5MB(5–10MB) | 按磁盘配额,百 MB 到 GB 级 |
| 生命周期 | 由 Expires / Max-Age 决定,否则随浏览器关闭失效 | 手动删除前一直存在 | 标签页关闭即清空 | 手动删除前一直存在 |
| 是否随请求发送 | 是,同域请求自动携带 | 否 | 否 | 否 |
| 数据类型 | 字符串 | 字符串 | 字符串 | 结构化对象、二进制 |
| API | document.cookie / Set-Cookie 头 | 同步 | 同步 | 异步,基于事务 |
| 适合存 | 会话 ID 等身份标识 | 偏好设置、小块配置 | 浏览足迹、表单草稿 | 离线数据、大量结构化数据、文件 |
面试速答模板
浏览器本地存储主要有三类。Cookie 的本职是给无状态的 HTTP 维持会话,单条只有 4KB 左右,而且同域请求都会自动携带,拿它存数据会让每个请求(包括图片、CSS)都变大,所以静态资源通常放在不设 Cookie 的独立域名上。Web Storage 是专门的存储方案,容量约 5MB,只在浏览器端,不随请求发送;其中 localStorage 持久保存、同源共享,sessionStorage 跟着标签页走,关闭就清空、不同标签页不共享。它们只能存字符串、API 同步,适合偏好设置、会话足迹这类少量简单数据。数据量大或结构复杂时用 IndexedDB,它是浏览器里的异步非关系型数据库,支持多库多表、索引、事务和二进制数据,容量按磁盘配额分配,实际开发常用 idb、Dexie 或 localForage 封装,再配合 Service Worker 和 Cache API 做 PWA 离线方案。