React 的栈调和(Stack Reconciler)
核心要点
- 调和和 Diff 不是一回事。调和(Reconciliation,也译作“协调”)指的是让内存里的虚拟 DOM 与页面上的真实 DOM 保持一致的整套流程,包括挂载、更新、卸载;Diff 只负责其中“比较新旧两棵树、找出差异”的那一步。
- 日常语境里说“栈调和”,基本就是指 React 15 的 Diff 算法。它用同步递归的方式遍历组件树,一旦开始就要跑完,中途让不出主线程,树一深就容易卡顿。React 16 起被 Fiber 调和取代。
- 从 O(n³) 降到 O(n) 靠三条假设:
- 跨层级移动很少见,所以只比较同一层的节点;
- 类型相同的组件产出的结构相似,所以类型不同就整棵替换,不再往下比;
- 同层的一组子节点可以用 key 标明身份,让节点在多次渲染之间被认出来、被复用。
- 跨层级挪动节点很贵:React 识别不出“移动”,只会把旧位置的子树销毁、在新位置重建一份。所以要尽量保持 DOM 结构稳定。
- key 要唯一、要稳定:拿数组下标当 key,一遇到插入、删除、排序,效果就和没写 key 差不多,甚至会把组件状态错配到别的条目上。
先分清两个概念:调和与 Diff
React 官方在解释虚拟 DOM 时给过定义,大意是:UI 的一份理想化表示保存在内存里,再由 ReactDOM 这类库把它同步到真实 DOM 上,这个同步的过程就叫协调(调和)。
抓住关键词“同步”,可以把两者的关系概括为:
| 调和(Reconciliation) | Diff | |
|---|---|---|
| 要回答的问题 | 怎样让真实 DOM 变得和虚拟 DOM 一致 | 新旧两棵虚拟 DOM 树哪里不一样 |
| 范围 | 挂载、更新、卸载组件的全过程 | 只出现在更新阶段 |
| 关系 | 整体 | 整体中的一个环节 |
React 15 的源码目录也能说明这一点。它大体分为 Core、Renderer、Reconciler 三块,调和器的代码在 src/renderers/shared/stack/reconciler 下面,里面除了比较子节点的逻辑,还有组件实例的创建、挂载、卸载等代码,Diff 只是更新时被调用的一部分。所以严格地说,调和 ≠ Diff,面试时能把这层区别讲出来,会显得基础扎实。
不过实际交流中,大家提到调和,关心的几乎总是 Diff。这样理解也说得通:Diff 是调和里最有代表性、也最能区分实现思路的一环,React 的调和器正是按 Diff 的实现方式分成两代的:
- 栈调和(Stack Reconciler):React 15 及以前,同步递归;
- Fiber 调和(Fiber Reconciler):React 16 起,可中断的循环。
面试官问到 Reconciliation,通常就是想听你讲 Diff。下文说的“栈调和”,指的也是 React 15 的 Diff 策略。
为什么后来换成了 Fiber
“栈”这个名字来自它的执行方式:组件树的比较靠函数层层递归完成,进度保存在 JavaScript 调用栈里。调用栈没法暂停后再接着跑,所以一次更新只要开始,就必须一口气比完整棵树。组件树很深时,这一次同步任务可能占住主线程几十甚至上百毫秒,期间用户输入和动画都得不到响应。
Fiber 把树的遍历改成了对链表结构的循环,每个 Fiber 节点就是一个可以单独执行的工作单元。React 每处理完一个单元,都可以检查有没有更高优先级的任务或者时间片是否用完,需要的话先把控制权还给浏览器,之后再从断点继续。React 18 的并发特性(startTransition、useDeferredValue 等)都建立在这个能力之上。
两者的本质差异可以用一句话记住:栈调和同步且不可中断,Fiber 调和可以拆分、可以中断、可以按优先级调度。 但“同层比较、类型不同就替换、靠 key 复用”这三条 Diff 策略,Fiber 时代仍然沿用。
为什么不能直接做“完整的树对比”
Diff 就是在找两棵树的差异。计算机科学里,求两棵任意树之间的最小编辑距离,经典算法的复杂度是 O(n³)。这已经是长期优化后的结果,但对浏览器来说仍然太贵:
| 节点数 n | n³ 量级 |
|---|---|
| 100 | 约 100 万次操作 |
| 1 000 | 约 10 亿次操作 |
一个页面有上百个节点再正常不过,而这只是一次更新的开销。刷算法题时,复杂度到了 O(n²) 就会想办法优化,O(n³) 显然没法接受。
React 的思路是:放弃求“最优解”,基于对真实 UI 的观察做几条假设,用一个足够好、复杂度为 O(n) 的启发式算法代替。官方给出的两条前提是:
- 两个组件类型相同,生成的 DOM 结构也相似;类型不同,结构就基本不同。
- 同一层级的一组子节点,可以通过
key标识,从而在不同次渲染之间保持身份稳定。
再加上一条来自实践的观察:
- DOM 节点很少跨层级移动,绝大多数改动发生在同一层内部。
这三条假设分别对应 Diff 的三个关键设计,下面逐个展开。
设计一:只做同层比较
根据第 3 条观察,React 干脆不再考虑跨层级的匹配。新旧两棵树只按层对齐:根和根比,第二层和第二层比,依此类推。这样从上往下遍历一遍就能比完整棵树,复杂度从 O(n³) 降到了 O(n),这是整个 Diff 优化中最关键的一步。
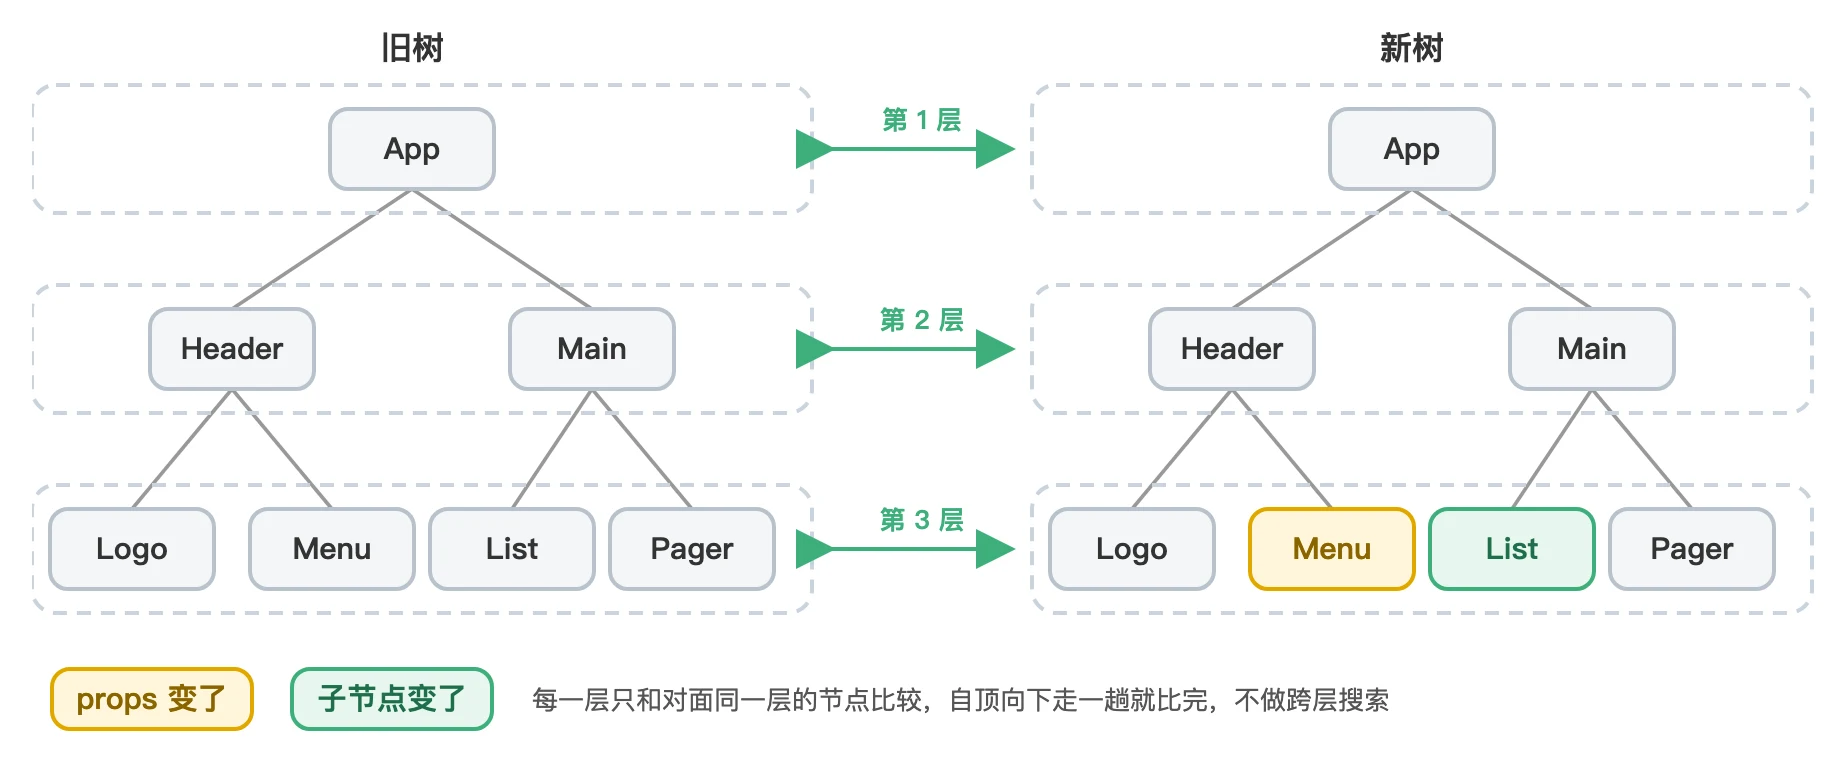
注意:同层比较只是限定了“和谁比”,并没有改变“怎么走”。栈调和遍历整棵树的方式仍然是递归,按层比较的递归也还是递归,前面说的“无法中断”的问题依然存在。
代价:跨层级移动会被当成“删一棵、建一棵”
假设页面里有个 Profile 子树,原来挂在 Sidebar 下面,一次更新后被挪到了 Content 下面:
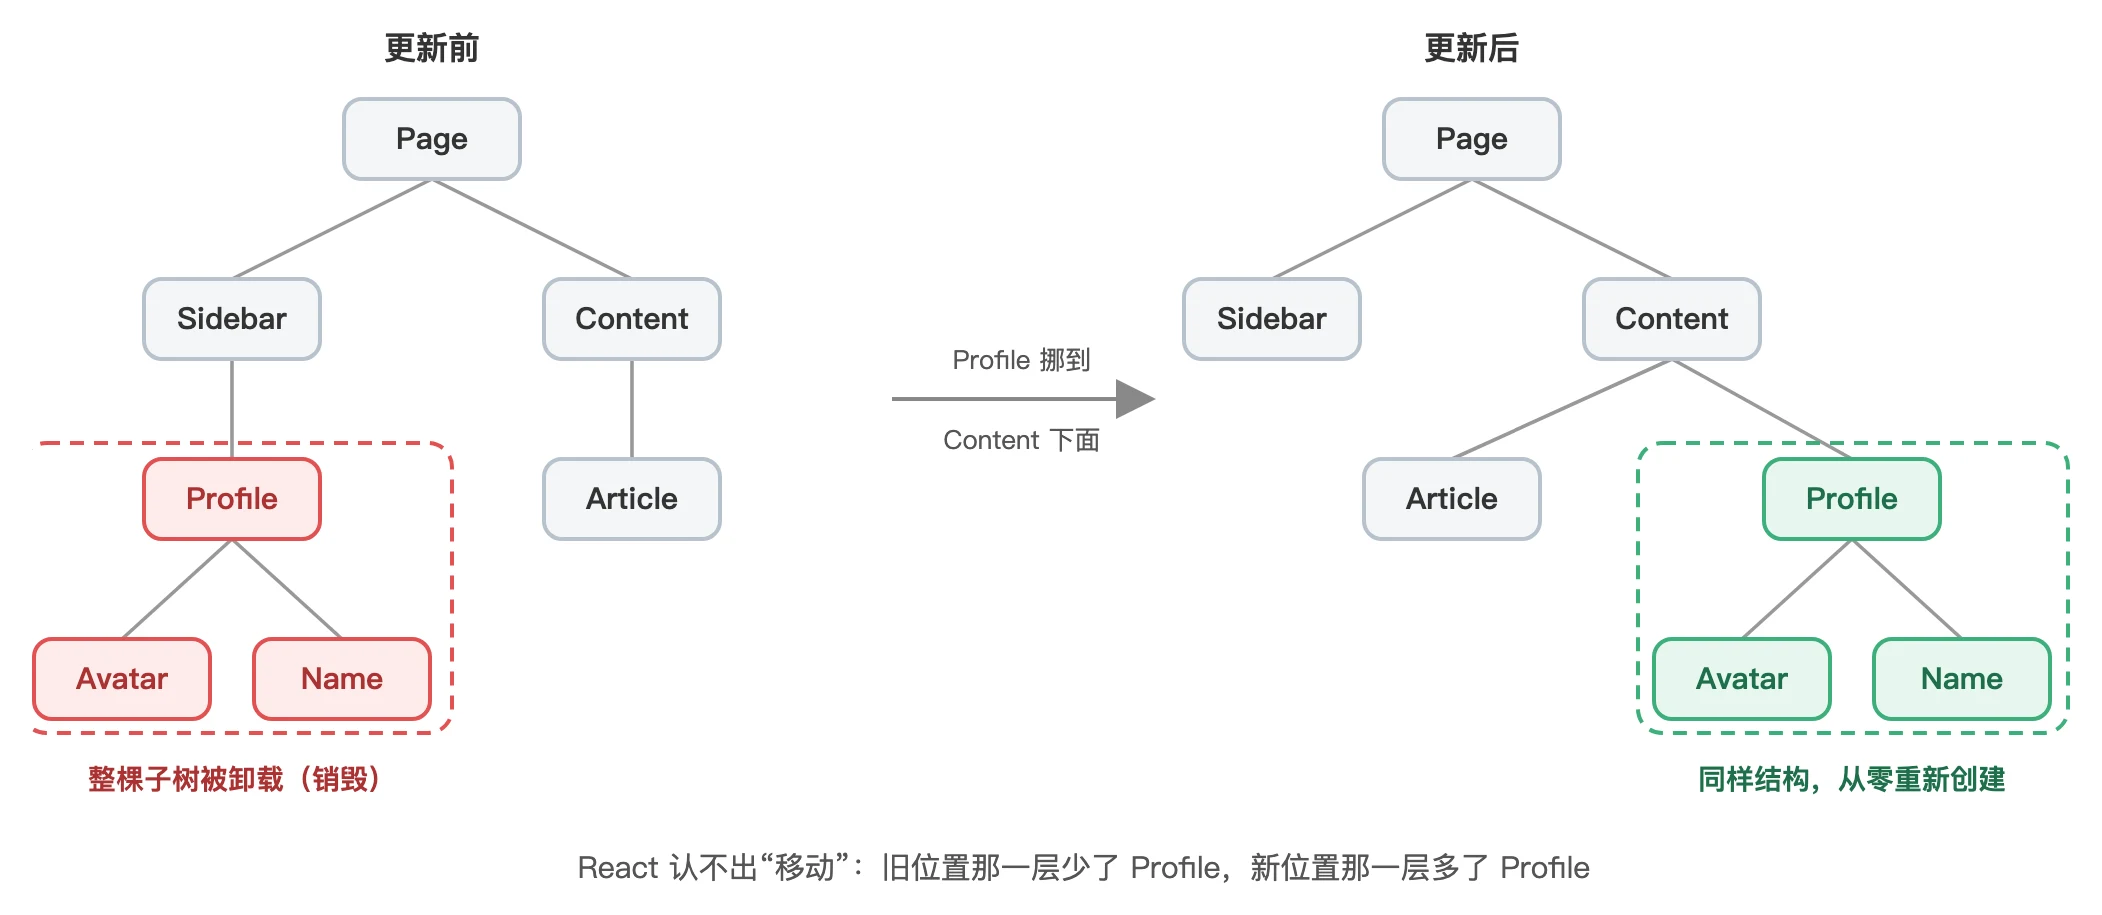
在只做同层比较的 Diff 看来,这不是移动,而是两件互不相关的事:
Sidebar那一层的子节点里少了Profile,于是把Profile及其所有后代全部卸载;Content那一层的子节点里多了一个Profile,于是从零创建一整棵新子树。
结果是 DOM 节点全部重建,Profile 子树里组件的内部状态(输入框内容、滚动位置、state 等)也会丢失。销毁加重建的成本很高,所以官方建议不要做跨层级的节点操作,尽量保持 DOM 结构稳定。如果只是想换个显示位置,用 CSS 控制,或者让组件始终挂在同一个父节点下、通过条件渲染内部内容,都比挪动子树更划算。
设计二:类型不同,直接整棵替换
第 1 条前提只说了“类型相同 → 结构相似”,严格来说推不出“类型不同 → 结构不同”。但在实际项目里,两个不同类型的组件恰好渲染出完全相同的 DOM,这种情况极少,为它做精细比较不值得。
所以 React 的规则很直接:只有类型相同的两个节点,才值得继续往下比较。比较一个位置上的新旧节点时:
- 类型不同(
<div>换成<span>、Card组件换成Panel组件),直接卸载旧节点及其整棵子树,在原位置挂载新节点及其子树,不再递归比较后代; - 类型相同,保留对应的 DOM 节点(或组件实例),只更新变化的属性,然后继续比较它们的子节点。
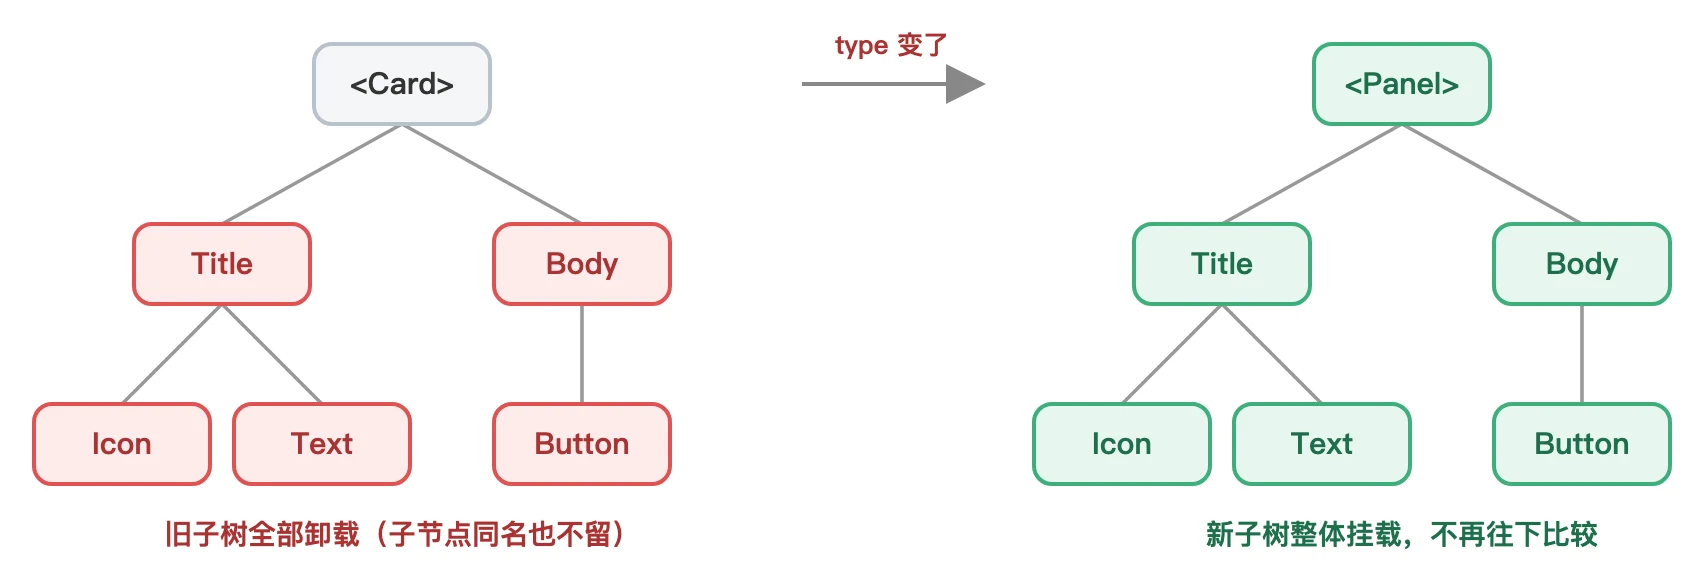
上图中,Card 和 Panel 的子节点名字一样,但 React 不会去复用它们,整棵子树都会重新创建。这条规则切掉了大量注定无用的递归,代价是偶尔会多重建一些本可以复用的节点。
日常开发中要注意它的一个副作用:不要在渲染函数里定义组件。
function ProductPage({ product }) {
  // 每次 ProductPage 渲染,PriceTag 都是一个新函数,也就是一个“新类型”
  const PriceTag = () => <span className="price">¥{product.price}</span>

  return <PriceTag />
}
每次渲染 PriceTag 都是一个新的函数引用,React 会认为类型变了,于是每次都卸载重建,里面的状态也每次都被清空。把组件定义移到外部就能避免。
设计三:用 key 让 React 认出同一个节点
不写 key 时会发生什么
前两条规则解决了跨层和换类型的情况,但同一层里最常见的操作——在列表中间插入一项——它们处理不好。
看一个例子:某个容器下原来有 Banner、Feed、Footer 三个子组件,现在在 Banner 和 Feed 之间插入一条 Notice。在没有 key 的情况下,React 只能按位置逐个配对:
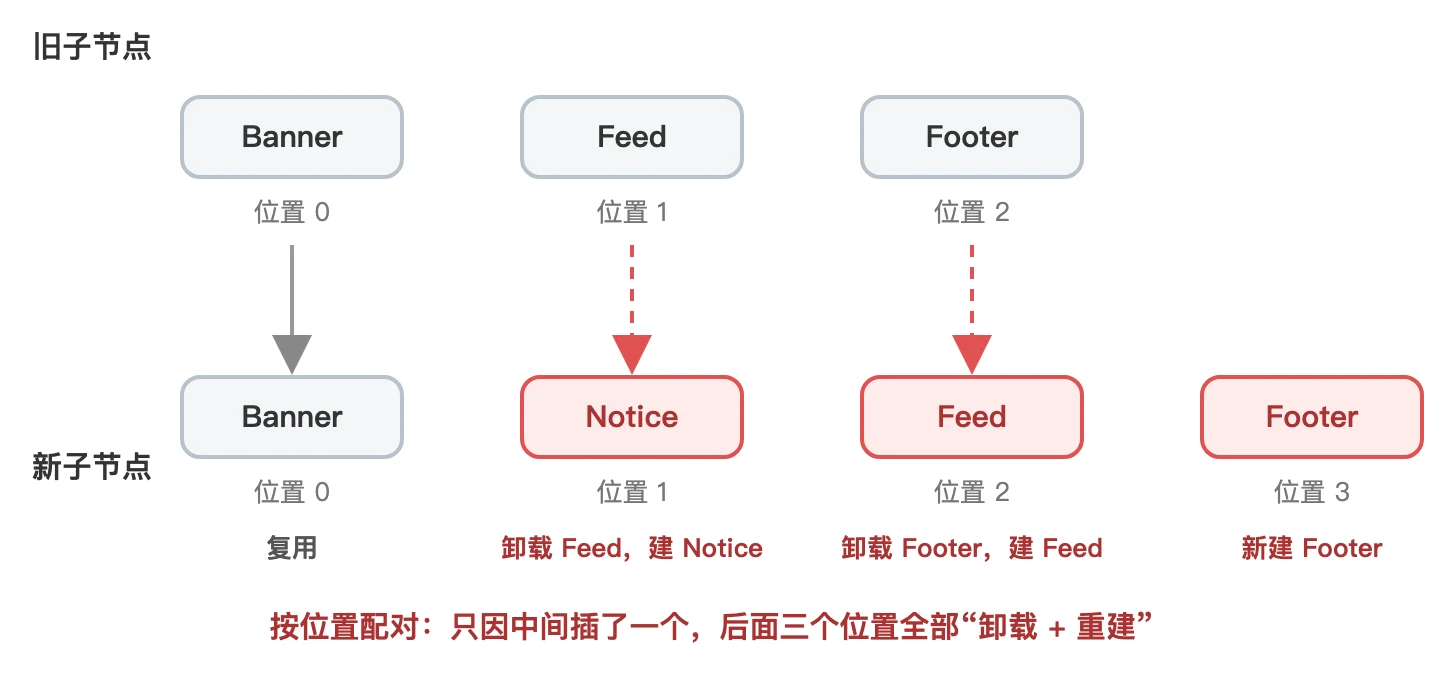
- 先比第 1 层:父容器类型没变,继续比子节点;
- 位置 0:
Banner对Banner,类型相同,复用; - 位置 1:旧的是
Feed,新的是Notice,类型不同,卸载Feed、创建Notice; - 位置 2:旧的是
Footer,新的是Feed,类型不同,卸载Footer、创建Feed; - 位置 3:旧树里没有节点,新建
Footer。
Feed 和 Footer 明明都还在,只是往后挪了一格,结果却被拆掉重建。本来插入一个节点就够了,最后变成了两次卸载、三次创建。跨层级移动可以靠约定避免,但往列表里插入、删除元素在业务中随时都会发生,躲不掉,所以必须有办法让 React 认出“谁还是谁”。
key 的作用
官方文档对 key 的说明是:key 帮助 React 识别哪些元素被修改、添加或删除了,应该给数组里的每个元素一个稳定的标识。
key 就是节点在同层兄弟之间的身份证。给上面的三个子组件都加上 key 之后,React 会先按 key 把新旧节点配对,再决定每个节点怎么处理:
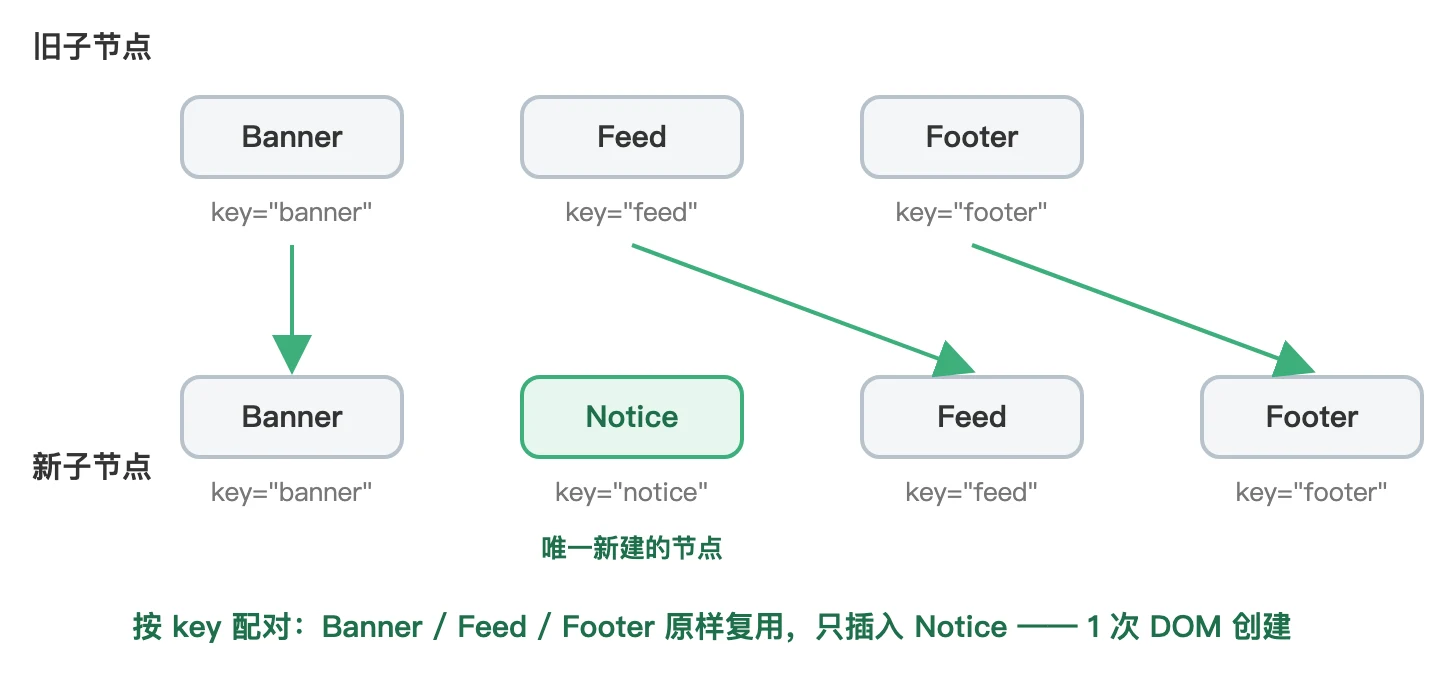
banner、feed、footer 三个 key 在新旧两边都能找到,对应的节点直接复用,最多调整一下 DOM 中的位置;notice 在旧节点里找不到,只有它需要新建。整个更新只产生一次 DOM 创建。
下面用一段可以直接用 node 运行的代码,模拟这两种配对方式。它只关注 type 和 key,不涉及真实 DOM:
// 按位置配对:不写 key 时的行为
function diffByIndex(prev, next) {
  const ops = [];
  const len = Math.max(prev.length, next.length);
  for (let i = 0; i < len; i++) {
    const before = prev[i], after = next[i];
    if (!before) ops.push(`创建 ${after.type}`);
    else if (!after) ops.push(`卸载 ${before.type}`);
    else if (before.type !== after.type) ops.push(`卸载 ${before.type} → 创建 ${after.type}`);
    else ops.push(`复用 ${after.type}`);
  }
  return ops;
}

// 按 key 配对:思路与 React 15 的子节点 Diff 一致
function diffByKey(prev, next) {
  const ops = [];
  const oldMap = new Map(prev.map((node, index) => [node.key, { node, index }]));
  let lastIndex = 0; // 已经访问过的旧节点里,最靠后的位置
  next.forEach((node) => {
    const hit = oldMap.get(node.key);
    if (hit && hit.node.type === node.type) {
      // 旧位置在 lastIndex 之前,说明它被换到了后面,需要移动
      if (hit.index < lastIndex) ops.push(`移动 ${node.type}`);
      else ops.push(`复用 ${node.type}`);
      lastIndex = Math.max(lastIndex, hit.index);
      oldMap.delete(node.key);
    } else {
      ops.push(`创建 ${node.type}`);
    }
  });
  oldMap.forEach(({ node }) => ops.push(`卸载 ${node.type}`));
  return ops;
}

const before = [
  { type: 'Banner', key: 'banner' },
  { type: 'Feed', key: 'feed' },
  { type: 'Footer', key: 'footer' },
];
const after = [
  { type: 'Banner', key: 'banner' },
  { type: 'Notice', key: 'notice' }, // 中间插入一条公告
  { type: 'Feed', key: 'feed' },
  { type: 'Footer', key: 'footer' },
];

console.log('按位置对比:', diffByIndex(before, after));
console.log('按 key 对比:', diffByKey(before, after));
输出:
按位置对比: [
  '复用 Banner',
  '卸载 Feed → 创建 Notice',
  '卸载 Footer → 创建 Feed',
  '创建 Footer'
]
按 key 对比: [ '复用 Banner', '创建 Notice', '复用 Feed', '复用 Footer' ]
diffByKey 里的 lastIndex 对应 React 15 的移动判断:按新顺序遍历,如果某个复用节点的旧下标比已访问节点的最大旧下标还小,说明它在新列表里被排到了后面,需要移动 DOM;否则原地不动。这个策略在“把最后一项挪到最前面”时表现较差(前面所有节点都会被判定为需要移动),面试中偶尔会被追问。
写法与常见警告
用数组渲染列表时,key 写在 map 返回的那个元素上:
function ContactList({ contacts }) {
  return (
    <ul>
      {contacts.map((contact) => (
        <ContactRow key={contact.uid} name={contact.name} phone={contact.phone} />
      ))}
    </ul>
  )
}
忘了写 key,React 不会报错,但开发环境的控制台会给出警告,提示列表里的每个子元素都应该有唯一的 key。这条警告出现得这么频繁,也说明了 key 的重要性:没有 key,Diff 就只能退回上面那种按位置配对的低效方式。
key 必须唯一且稳定
key 是节点的身份标识,所以有两条硬要求:
- 唯一:同一层兄弟之间不能重复(不需要全局唯一)。重复的 key 会让 React 无法区分节点,出现渲染错乱,开发环境也会给出警告。
- 稳定:同一条数据在每次渲染中的 key 要保持不变。不要用
Math.random()或每次重新生成的值,否则每次渲染 key 都不同,所有节点都会被卸载重建。
用数组下标 index 当 key 是最常见的反例。列表只追加、不插入、不删除、不排序时,用下标问题不大;但只要在头部或中间插入一项,后面所有元素的下标都会变化,key 和数据的对应关系被打乱:
- 性能上,React 以为每个位置都“还是原来那个节点”,只是内容全变了,于是逐个更新属性,相当于退化成没有 key 的按位置比较;
- 正确性上,如果列表项里有自己的状态(比如未受控的
<input>、展开/收起状态),这些状态会留在原来的下标上,跑到别的数据项下面去。
所以,有后端 id 等稳定标识就用它当 key;实在没有,可以在数据进入组件之前生成一次并保存下来。
补充:key 变了,React 会把它当成一个全新的元素,卸载旧组件、挂载新组件。这一点可以主动利用,比如
<EditForm key={userId} />,切换用户时让表单整个重置,不必手动清理状态。
面试速答模板
调和是让虚拟 DOM 和真实 DOM 保持一致的整个过程,包括挂载、更新和卸载,Diff 只是更新时找差异的那一步,不过面试里说调和一般就是指 Diff。栈调和是 React 15 的实现,靠同步递归遍历组件树,一旦开始就不能中断,树一深就会长时间占用主线程,所以 React 16 换成了可中断、可按优先级调度的 Fiber 调和。传统的树对比是 O(n³),React 基于三条假设把它降到了 O(n):第一,只比较同一层的节点,跨层级移动会被当成销毁加重建,所以要保持结构稳定;第二,节点类型不同就直接替换整棵子树,不再往下比较;第三,同层子节点用 key 标识身份,插入、删除、排序时可以按 key 找到旧节点复用,而不是按位置逐个替换。key 必须在兄弟间唯一,并且在多次渲染之间保持稳定,用数组下标当 key 在插入、删除时会退化,还可能导致组件状态错位。