HTTP 的缓存控制
核心要点
| 主题 | 记住这一句 |
|---|---|
| 字段方向 | Cache-Control 是双向的:服务器在响应里用它下达缓存策略,浏览器在请求里用它表达「我要多新的数据」 |
max-age | 资源的新鲜期,单位秒。起算点是服务器生成响应的那一刻(Date),路上花掉的时间也要扣掉,不是从浏览器收到时开始算 |
no-store | 彻底不许存,每次都重新下载 |
no-cache | 名字有误导性:可以存,但每次拿出来用之前都得先找服务器确认 |
must-revalidate | 新鲜期内随便用;一旦过期,不经服务器确认就不准再用 |
| 条件请求 | 两对「请求头 ↔ 响应头」:If-Modified-Since ↔ Last-Modified(按时间判断),If-None-Match ↔ ETag(按标识判断,更精确) |
304 Not Modified | 服务器说「没变」,响应里不带正文,浏览器刷新有效期后继续用本地副本 |
| 强 / 弱 ETag | 强 ETag 要求逐字节一致;弱 ETag 带 W/ 前缀,只要求内容含义没变 |
| 刷新按钮 | 普通刷新:请求头带 Cache-Control: max-age=0;强制刷新(Ctrl+F5 / Cmd+Shift+R):请求头带 Cache-Control: no-cache |
| 其他细节 | Expires 和 Pragma 是旧字段;没有显式有效期时浏览器会按 (Date − Last-Modified) × 10% 估算;ETag 的生成算法由服务器自己决定 |
一句话概括 HTTP 缓存:能不发的请求就不发,非发不可就只问一句「变了没有」,没变就别把正文再传一遍。
先建立一个直观印象
拿出门坐火车打个比方。你去车站拍了一张列车时刻表存在手机相册里,车站在表的角落印着一行小字:「本表 7 天内有效」。之后想查车次,翻相册就行,不用每次跑一趟车站。
对应到 HTTP:
| 比喻里的角色 | HTTP 里的角色 |
|---|---|
| 车站 | Web 服务器 |
| 你 | 浏览器 |
| 手机相册 | 浏览器的本地缓存 |
| 「7 天内有效」 | 响应头里的 Cache-Control: max-age=... |
第一次访问一个资源时,完整过程是这样的:
- 浏览器先翻缓存,发现没有;
- 只好向服务器发请求;
- 服务器返回资源,并在响应头里写明这份资源能用多久;
- 浏览器把资源连同有效期一起存起来,下次直接用。
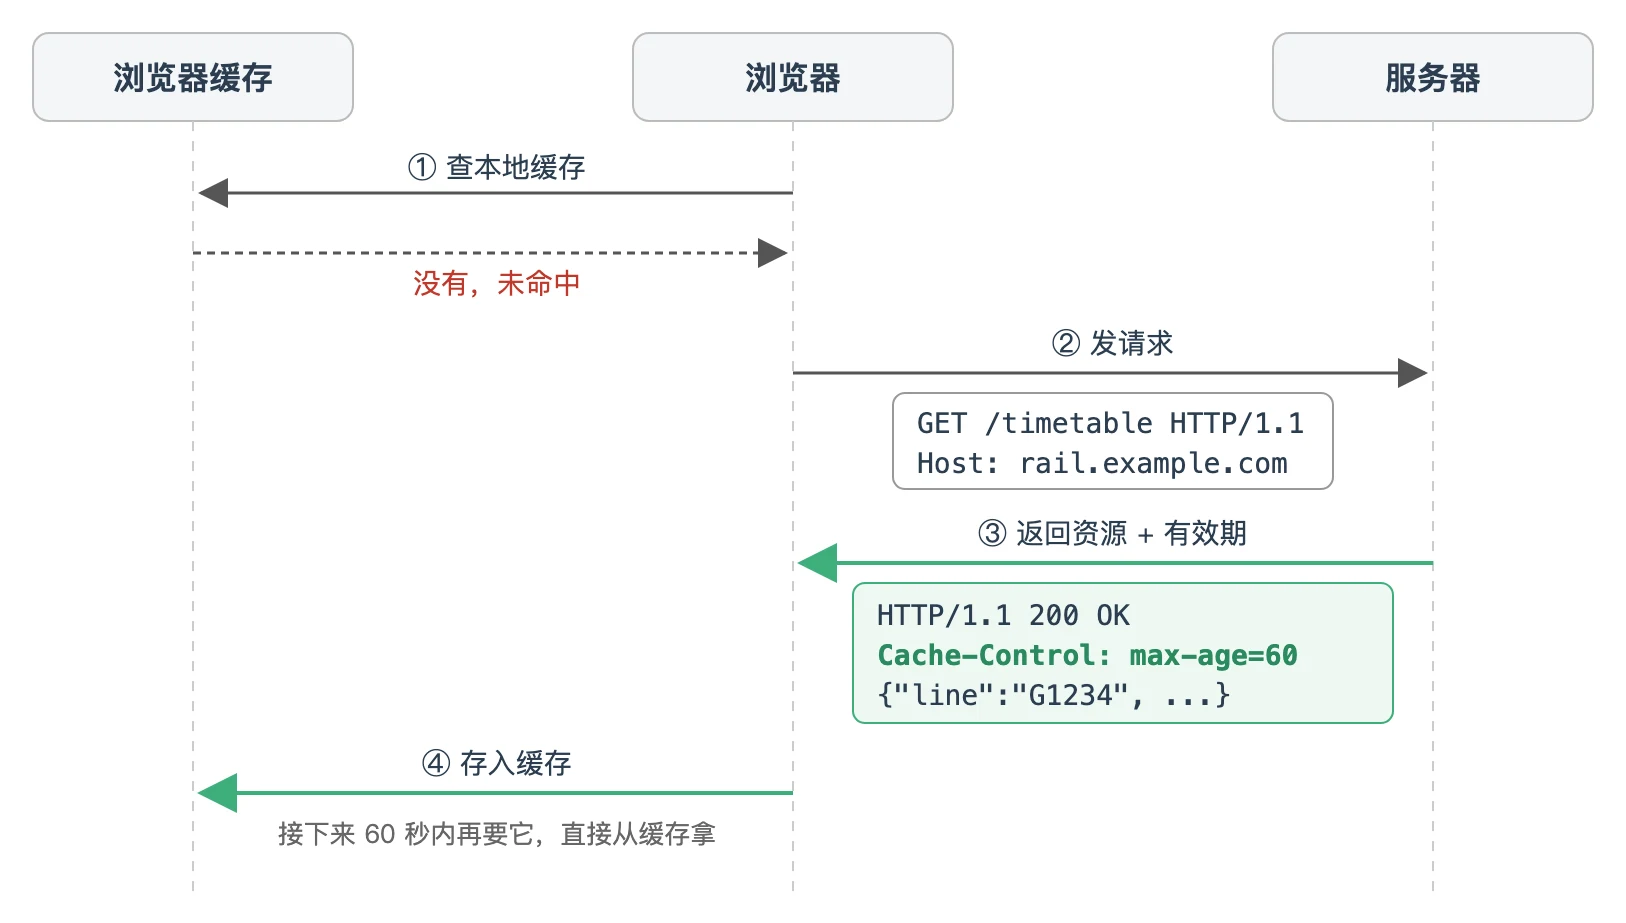
图里的 Cache-Control: max-age=60 就是服务器给的话:「这份数据在 60 秒内可以直接拿来用,超过 60 秒就算过期了。」
为什么不让浏览器一直存着用? 因为服务器上的数据随时可能更新。时刻表会调整,站台会变,一张两个月前拍的时刻表照着去赶车,大概率误车。有效期就是服务器对「这份数据多久内大概率不会变」的承诺。
服务器这一侧:用 Cache-Control 下达策略
max-age:新鲜期从哪一刻算起
max-age 和 Cookie 里的 Max-Age 很像,都是在给数据设一个寿命。HTTP 规范里管它叫 freshness lifetime(新鲜期),跟 DNS 里的 TTL(Time-To-Live)是一个思路。
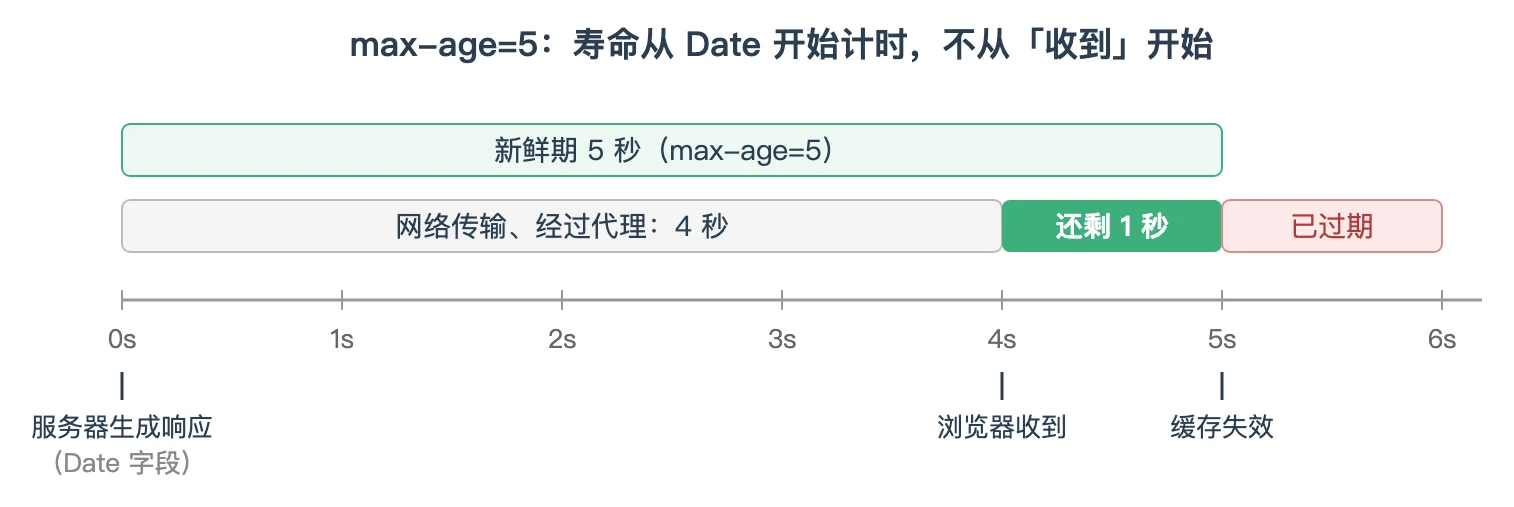
容易答错的一点是起算时间:它从服务器生成这条响应开始计时,也就是响应头 Date 记录的时刻,而不是浏览器收到响应的时刻。这条响应在网络里传输、在各级代理里停留的时间,都要算进它的「年龄」里(经过代理缓存时,代理还会用 Age 头告诉下游自己已经存了多少秒)。
举个极端情况:服务器设了 max-age=5,网络很差,响应在路上耗了 4 秒,那么浏览器拿到手时它只剩 1 秒新鲜期。
下面用一小段代码把这个计算过程写出来(简化版,忽略了 Age 头和时钟误差修正)。顺带把后面会讲到的 Expires 和「启发式有效期」也放进去:
// freshness.mjs:估算一份缓存还能新鲜多久
function freshnessLifetime(headers) {
  const cc = headers['cache-control'] || '';
  const maxAge = /(?:^|,)\s*max-age=(\d+)/.exec(cc);
  if (maxAge) return Number(maxAge[1]);
  if (headers.expires) return (Date.parse(headers.expires) - Date.parse(headers.date)) / 1000;
  if (headers['last-modified']) {
    // 没有显式有效期:启发式 = (Date - Last-Modified) * 10%
    return ((Date.parse(headers.date) - Date.parse(headers['last-modified'])) / 1000) * 0.1;
  }
  return 0;
}

function remaining(headers, receivedAt) {
  // 年龄从服务器生成响应(Date)开始算,路上耽误的时间也算进去
  const age = (receivedAt - Date.parse(headers.date)) / 1000;
  return freshnessLifetime(headers) - age;
}

const sentAt = Date.parse('2026-10-02T10:00:00Z');

// 例 1:max-age=5,网络慢,4 秒后才到
console.log('例1 剩余秒数', remaining(
  { date: new Date(sentAt).toUTCString(), 'cache-control': 'max-age=5' },
  sentAt + 4000,
));

// 例 2:只有 Expires
console.log('例2 剩余秒数', remaining(
  { date: new Date(sentAt).toUTCString(), expires: new Date(sentAt + 3600e3).toUTCString() },
  sentAt + 1000,
));

// 例 3:只有 Last-Modified,文件 10 天前改过 -> 启发式 1 天
console.log('例3 有效期(小时)', freshnessLifetime({
  date: new Date(sentAt).toUTCString(),
  'last-modified': new Date(sentAt - 10 * 86400e3).toUTCString(),
}) / 3600);
用 node freshness.mjs 运行,输出:
例1 剩余秒数 1
例2 剩余秒数 3599
例3 有效期(小时) 24
另外三个常用指令
max-age 是最常见的写法,但光有它还不够细。服务器还能在响应的 Cache-Control 里加上这些值:
| 指令 | 准确含义 | 典型场景 |
|---|---|---|
no-store | 任何缓存都不许保存这份响应 | 变化极快的数据(比如抢购倒计时页),或者不该落盘的敏感数据(网银账单) |
no-cache | 可以保存,但每次使用前都必须向服务器验证一遍,确认还是最新版本才能用 | HTML 入口页:既想省流量,又必须保证用户拿到最新版本 |
must-revalidate | 没过期时照常直接用;过期之后必须向服务器验证,不能「先凑合用着」 | 过期数据一旦被使用就会出问题的资源,比如价格、库存 |
no-cache 和 no-store 最容易被混为一谈,面试也最爱问。记住:no-store 是不存,no-cache 是存了但不信,用前必问。
must-revalidate 看起来和 no-cache 也像,区别在于验证的时机。no-cache 是每次使用都要验证;must-revalidate 只在过期以后才强制验证。为什么需要专门强调「过期后必须验证」?因为 HTTP 规范允许缓存在某些情况下(比如连不上服务器)把过期的响应先拿出来用,must-revalidate 就是把这条退路堵死:验证不了就返回错误(通常是 504),也不能交出过期数据。
还是用时刻表来对照:
no-store:车站不许拍照,想看只能每次到现场看;no-cache:可以拍照存着,但每次要照着坐车之前,都得打个电话问车站「表还是这张吗」;must-revalidate:7 天内随便看;过了 7 天,必须先打电话确认,打不通就别用这张照片。
把选择过程画成一张决策图
写后端接口时,可以按下面三个问题依次判断该返回什么样的 Cache-Control:
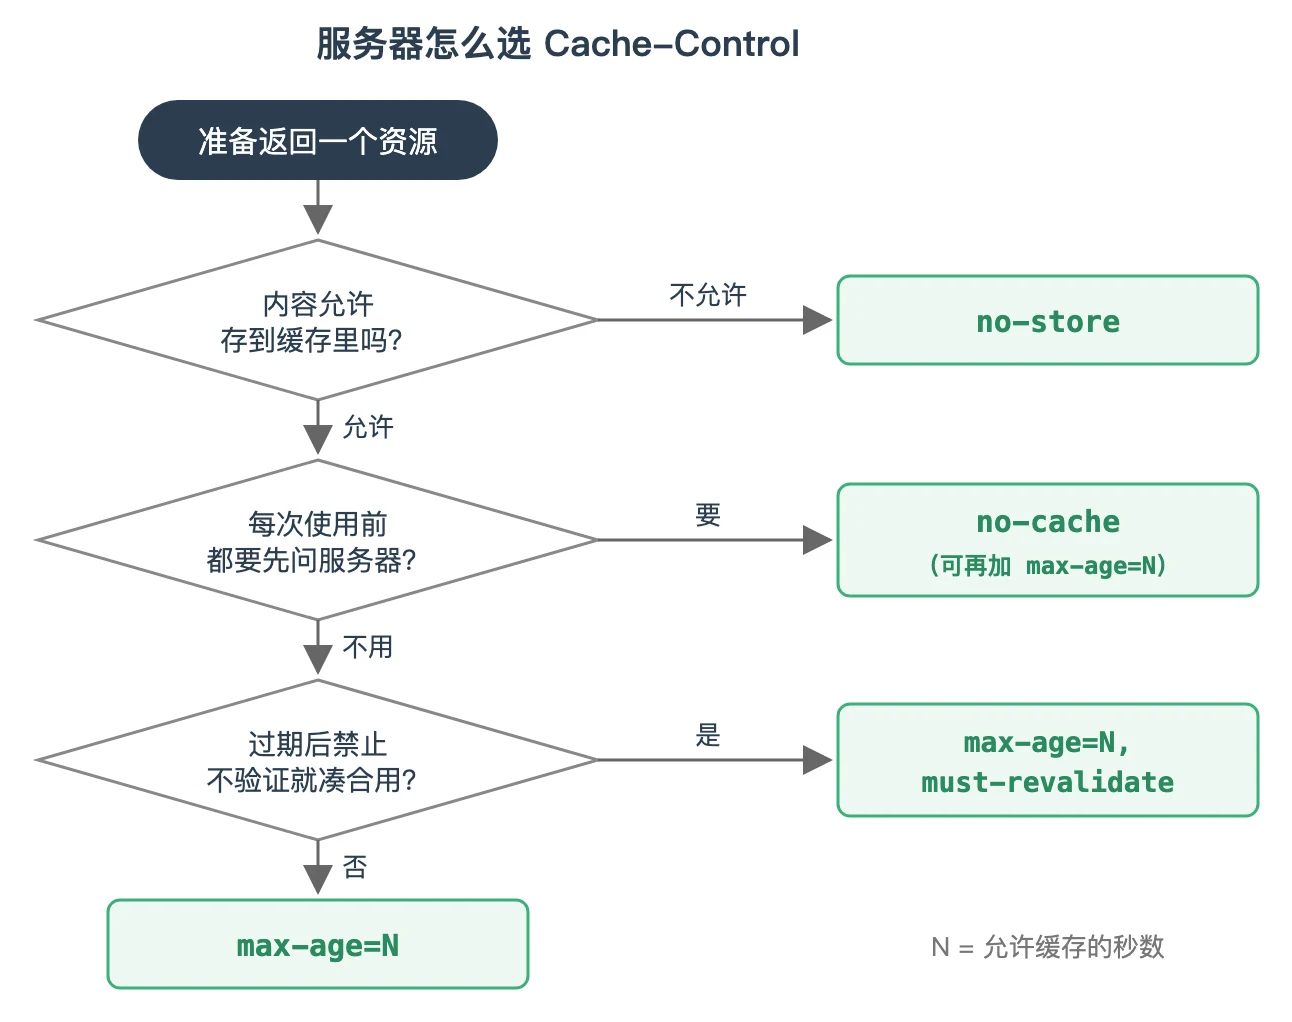
指令之间可以组合,用逗号分隔,比如 Cache-Control: max-age=600, must-revalidate。图里的 no-cache 分支同样可以再带上 max-age,写成 no-cache, max-age=600:每次使用前照样要验证,max-age 留给不认识 no-cache 的旧缓存或下游代理参考。
现代前端的常用组合
实际项目里,最常见的是两种资源两套策略:
# 构建产物:文件名里带内容哈希,例如 app.3f9c2a.js
Cache-Control: public, max-age=31536000, immutable

# 入口 HTML:每次都要确认是不是新版本
Cache-Control: no-cache
- Vite、Webpack 这类构建工具会把内容哈希写进文件名。文件内容一改,哈希跟着变,URL 也就变了,对浏览器来说是一个全新的资源。所以旧 URL 可以放心缓存一年。
immutable(RFC 8246)告诉浏览器:这份资源在有效期内绝对不会变,连用户点刷新时也不用发条件请求去问,省掉一次 304 往返。- 入口 HTML 用
no-cache,保证每次发布新版本后用户都能拿到引用新哈希文件的 HTML。 - 另一个常用扩展是
stale-while-revalidate=<秒>(RFC 5861):缓存刚过期的这段宽限期内,先把旧副本交给用户,同时在后台悄悄去服务器更新,兼顾响应速度和数据新鲜度。 - 如果中间有 CDN 或代理,还会用到
public/private(允许 / 不允许共享缓存存储)和s-maxage(只对共享缓存生效的有效期),这部分属于代理缓存的话题。
浏览器这一侧:请求里也能带 Cache-Control
为什么点刷新时缓存「不起作用」
假设服务器设了 max-age=60,你在 60 秒内连续点浏览器的刷新按钮,打开 DevTools 的 Network 面板一看:每次都发了请求,并没有直接用缓存。这不是缓存坏了。
原因是 Cache-Control 不只服务器能发,浏览器也能在请求头里发。请求双方都可以用这个字段表达自己对缓存的要求,最终怎么用缓存是两边协商的结果。
当你点普通刷新时,浏览器会在请求头里加上:
Cache-Control: max-age=0
请求里的 max-age 意思是「我只接受年龄不超过这么多秒的数据」。max-age=0 等于说「我要此刻最新的」,本地缓存哪怕只存了一秒也不满足条件,于是浏览器不会直接用缓存,而是去问服务器。服务器(或中间的代理)看到这个要求,也不会把自己缓存的旧响应直接交出来。
强制刷新又是什么
按 Ctrl+F5(macOS 上是 Cmd+Shift+R)做强制刷新时,请求头变成:
Cache-Control: no-cache
Pragma: no-cache
请求里的 no-cache 和 max-age=0 意思差不多,都是「不要直接给我缓存里的东西」,具体怎么处理取决于服务器,多数情况下效果相同。
补充(实际浏览器行为):两者的真正差别在于是否带上条件请求头。普通刷新时,浏览器会同时带上
If-None-Match/If-Modified-Since,资源没变就能拿到一个轻量的 304;强制刷新会把这些校验头去掉,服务器只能返回完整的 200。另外,Chrome 从 2017 年前后起优化了普通刷新:只对页面主文档重新验证,页面里的图片、脚本等子资源仍按正常的缓存规则加载,不再逐个发验证请求。
条件请求:只问「变了没有」
从「两次请求」到「一次请求」
缓存总会过期,过期之后、或者遇到 no-cache 时,浏览器都得找服务器确认手里的副本还能不能用。而前面那种请求头里带 max-age=0 的方式,只是让浏览器绕开缓存重新拿数据,本地已有的副本完全没派上用场。
最笨的验证办法是拆成两步:先发一个 HEAD 请求,只拿资源的元信息(比如修改时间),和本地副本对比;没变就用本地的,变了再发一个 GET 把新版本取回来。这样虽然能省下正文的流量,但多了一次网络往返,代价太高。
HTTP 的做法是定义了一组以 If 开头的请求头,叫做条件请求。浏览器把「我手里副本的标识」放进请求里,判断工作交给服务器:没变就回一句「没变」,变了就直接把新内容放在同一个响应里返回。原来两个请求的事,一个请求就办完了,浏览器只需要等结果。
条件请求头一共有 5 个:
| 请求头 | 搭配的响应头 | 用途 |
|---|---|---|
If-Modified-Since | Last-Modified | 缓存验证:在这个时间之后改过吗?没改就回 304 |
If-None-Match | ETag | 缓存验证:标识还是这个吗?是就回 304 |
If-Unmodified-Since | Last-Modified | 只有在这个时间之后没改过才执行请求,否则回 412,常用于防止并发覆盖 |
If-Match | ETag | 只有标识仍然匹配才执行请求,否则回 412,常用于乐观锁式的更新(PUT/PATCH) |
If-Range | ETag 或 Last-Modified | 和 Range 一起用于断点续传:资源没变就只返回剩下那段(206),变了就返回完整新文件(200) |
缓存场景天天用到的是前两个。用法的前提是:第一次响应时,服务器得先把 Last-Modified 或 ETag 发下来,浏览器存进缓存;以后再请求时,把存下的值原样放进 If-Modified-Since 或 If-None-Match 里带上去。
如果资源没有变化,服务器回一个 304 Not Modified。这个响应只有状态行和头部,没有正文。浏览器收到后用它更新本地副本的有效期,然后接着用缓存里的那份内容。
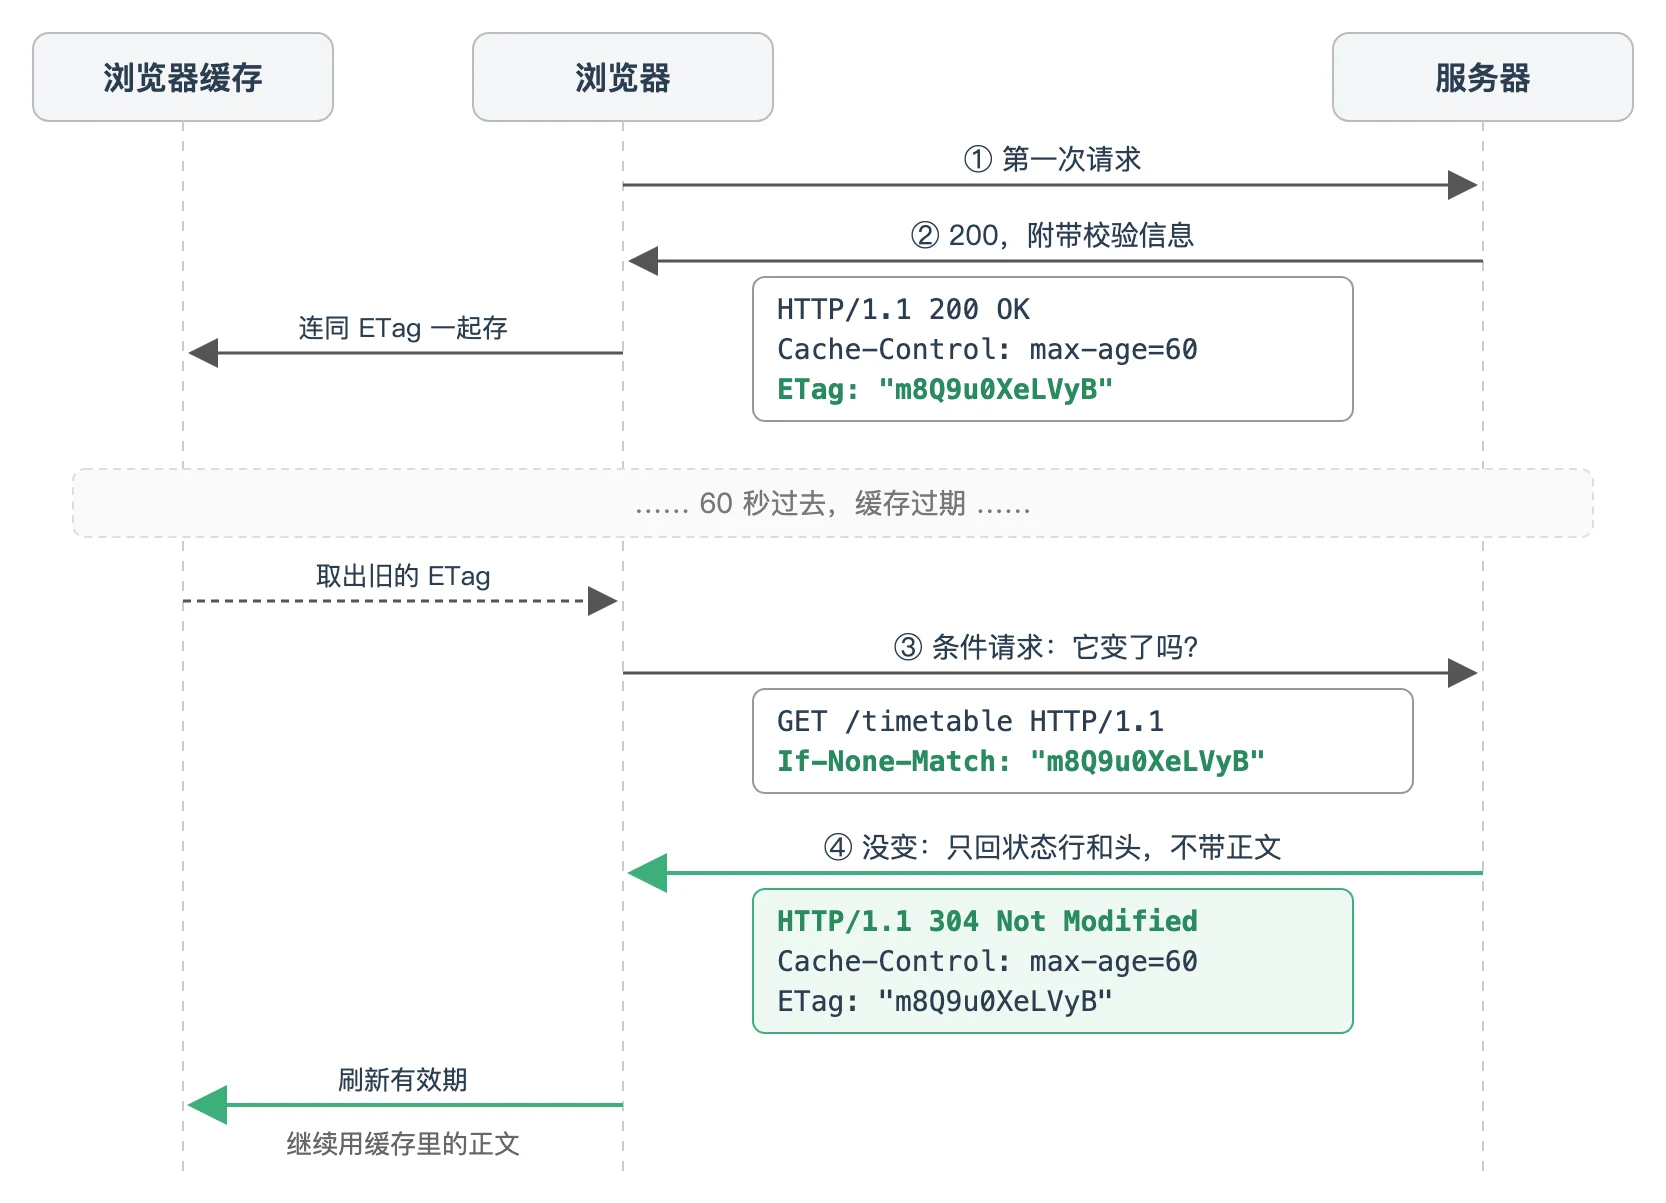
Last-Modified 与 ETag
Last-Modified 就是资源最后一次修改的时间,容易理解。那为什么还需要 ETag?
ETag 是 Entity Tag(实体标签)的缩写,是服务器给资源当前版本算出的一个标识,作用是弥补「按修改时间判断」的两个漏洞:
- 精度不够:HTTP 日期格式只精确到秒。一个文件如果在同一秒里被改了好几次,这几个版本的
Last-Modified完全一样,按时间根本区分不出来。 - 时间变了,内容没变:比如一个定时任务每小时重新生成一次文件,很多时候生成出来的内容和上次一模一样,但修改时间刷新了。按时间判断就会误认为有变化,把同样的内容再传一遍,白白浪费带宽。
ETag 直接反映内容版本,能准确识别资源到底有没有变,缓存的利用率也就更高。两个头同时出现时,服务器应当以 If-None-Match 为准,If-Modified-Since 只作为退路。
强 ETag 与弱 ETag
ETag 分两种:
| 类型 | 写法 | 判定标准 |
|---|---|---|
| 强 ETag | ETag: "a1b2c3" | 两个版本必须逐字节完全相同 |
| 弱 ETag | ETag: W/"a1b2c3" | 只要求语义上等价,允许细节不同,比如 HTML 里多了几个空格、属性顺序调了一下 |
什么时候会用弱 ETag?典型例子是开启了 gzip 动态压缩的服务器:同一份内容压缩前后字节不同,但对用户来说是同一个东西,nginx 在这种情况下就会把强 ETag 降级成弱 ETag。
If-None-Match 做的是「弱比较」:忽略 W/ 前缀,只比引号里的值,所以弱 ETag 照样能换来 304。而 If-Match、If-Range 这种涉及「修改」或「拼接字节片段」的场景必须用强比较,弱 ETag 不能匹配,否则拼出来的文件可能是错的。
用时刻表再走一遍
还是那张拍下来的时刻表,三种问法对应三种验证方式:
- 按时间问(
If-Modified-Since):你打电话问「我这张是 9 月 30 号早上 8 点拍的,之后改过吗?」车站说「8 点以后没动过」。那就接着用手机里的照片。 - 按版本号问,宽松比较(
If-None-Match+ 弱 ETag):时刻表右下角印着版本号「第 37 版」。你问「现在还是第 37 版吗?」车站说「是,只是重新排了一下字体」。内容没变,照片继续用。 - 按版本号问,严格比较(强 ETag):车站回答「第 37 版里 G1234 的站台从 3 号改成了 5 号,现在是第 38 版」。连一个字都不一样,照片作废,车站把新版直接发给你。
动手验证:一个会回 304 的小服务
下面用 Node.js 写一个最小的服务,返回带 max-age、ETag、Last-Modified 的「时刻表」,并且处理条件请求。脚本启动后自己扮演客户端,依次发出几种请求:
// cache-demo.mjs:演示 Cache-Control、ETag、Last-Modified 和 304
import http from 'node:http';
import { createHash } from 'node:crypto';

let timetable = { line: 'G1234', departs: '08:15', platform: 3 };
let updatedAt = new Date('2026-09-30T08:00:00Z');

function buildEtag(body) {
  // 用内容摘要做强 ETag:字节变了,值一定变
  return '"' + createHash('sha1').update(body).digest('base64url').slice(0, 12) + '"';
}

// If-None-Match 用「弱比较」:去掉 W/ 前缀后比较引号里的值
function etagMatches(header, current) {
  if (!header) return false;
  if (header.trim() === '*') return true;
  const strip = (t) => t.trim().replace(/^W\//, '');
  return header.split(',').some((t) => strip(t) === strip(current));
}

const server = http.createServer((req, res) => {
  const body = JSON.stringify(timetable);
  const etag = buildEtag(body);
  const lastModified = updatedAt.toUTCString();

  res.setHeader('Cache-Control', 'max-age=60');
  res.setHeader('ETag', etag);
  res.setHeader('Last-Modified', lastModified);

  const inm = req.headers['if-none-match'];
  const ims = req.headers['if-modified-since'];
  // 两个都带时,以 If-None-Match 为准
  const notModified = inm
    ? etagMatches(inm, etag)
    : ims && Math.floor(updatedAt / 1000) <= Math.floor(Date.parse(ims) / 1000);

  if (notModified) {
    res.statusCode = 304; // 不带响应体
    return res.end();
  }
  res.setHeader('Content-Type', 'application/json');
  res.end(body);
});

server.listen(0, async () => {
  const url = `http://127.0.0.1:${server.address().port}/timetable`;
  const show = async (label, headers = {}) => {
    const r = await fetch(url, { headers });
    const text = await r.text();
    console.log(`${label} -> ${r.status} etag=${r.headers.get('etag')} body=${text.length}B`);
    return r;
  };

  const first = await show('首次请求');
  const etag = first.headers.get('etag');
  const lm = first.headers.get('last-modified');

  await show('带 If-None-Match', { 'If-None-Match': etag });
  await show('带弱 ETag 的 If-None-Match', { 'If-None-Match': 'W/' + etag });
  await show('带 If-Modified-Since', { 'If-Modified-Since': lm });

  timetable = { ...timetable, platform: 5 }; // 站台变更
  updatedAt = new Date('2026-09-30T09:30:00Z');
  await show('时刻表更新后再验证', { 'If-None-Match': etag });

  server.close();
});
node cache-demo.mjs 的输出(Node 18+ 自带 fetch):
首次请求 -> 200 etag="m8Q9u0XeLVyB" body=47B
带 If-None-Match -> 304 etag="m8Q9u0XeLVyB" body=0B
带弱 ETag 的 If-None-Match -> 304 etag="m8Q9u0XeLVyB" body=0B
带 If-Modified-Since -> 304 etag="m8Q9u0XeLVyB" body=0B
时刻表更新后再验证 -> 200 etag="gn-n8uYNJfZU" body=47B
可以看到:标识或时间对得上时,服务器回 304,正文长度是 0;数据一改,ETag 随之变化,同样的条件请求就拿到了新的 200。在浏览器里打开这类接口并点普通刷新,请求头会同时出现 Cache-Control: max-age=0 和 If-None-Match,只要资源没变,Network 面板里就会看到 304。
另外三个条件请求头(If-Unmodified-Since、If-Match、If-Range)只是把判断方向反过来或用在别的场景,掌握了上面这两个,那三个照着表格就能推出来。
几个容易忽略的细节
- 查看本地缓存:Chrome 66 以前可以在地址栏输入
chrome://cache浏览缓存内容,后来出于安全考虑被移除了。现在看缓存命中情况,用 DevTools Network 面板的 Size 列,显示(memory cache)或(disk cache)的就是直接从缓存拿的。 no-cache约等于max-age=0, must-revalidate:都是「存下来,但每次用前都要验证」。细微差别在于,no-cache在任何情况下都不允许不验证就使用,语义更直接,现在一般直接写no-cache。Expires和Pragma:- 除了
Cache-Control,服务器还能用Expires标记过期时间。它写的是一个绝对时间点,格式和 Cookie 的Expires一样,是 HTTP/1.0 留下来的老字段。它依赖客户端时钟准确,两者同时出现时max-age优先。 Pragma: no-cache也是 HTTP/1.0 的遗留物,作为请求头时相当于Cache-Control: no-cache。除非要兼容只认 HTTP/1.0 的老缓存,否则没必要再写;规范也没定义它出现在响应里的含义,响应里写它不可靠。
- 除了
- 启发式有效期:响应里有
Last-Modified,却既没有Cache-Control也没有Expires时,浏览器不会认为「不能缓存」,而是自己估一个有效期。规范(RFC 9111)建议的估算方式是(Date − Last-Modified) × 10%:一个 10 天没改过的文件,大约会被缓存 1 天(见前面 freshness.mjs 的例 3)。不想被这样「猜」,就显式写上Cache-Control。 - ETag 怎么算由服务器决定:规范只要求内容变了,ETag 就得变,具体算法各家不同。对内容做哈希最精确,但大文件每次都算会给服务器增加负担。nginx 对静态文件的做法是「修改时间 + 文件长度」,各自转成十六进制拼起来。拿前面 cache-demo 里的时刻表来说,假如它是 nginx 托管的一个静态文件,修改时间 2026-09-30 08:00 UTC(Unix 时间戳
0x6abcc180),长度 47 字节(0x2f),ETag 就是"6abcc180-2f"。这种算法本质上和Last-Modified差不多精确。多台服务器做负载均衡时,要保证各节点给同一个文件算出相同的 ETag,否则缓存验证会频繁失败。
小结
- 缓存是提升性能最有效的手段之一,从浏览器、代理、CDN 到源站,HTTP 链路的每一环都可以缓存;
- 服务器通过响应头
Cache-Control下达缓存策略,最常用的是max-age,表示资源能新鲜多久;no-store、no-cache、must-revalidate用来更细地控制; - 浏览器拿到响应就会存进缓存:新鲜期内直接用,过期了要先找服务器验证还能不能用;
- 验证靠条件请求,常用的两个头是
If-Modified-Since与If-None-Match;服务器回 304 时,浏览器继续用本地副本; - 条件请求要用到的
Last-Modified和ETag必须由服务器在之前的响应里先给出; - 浏览器也会在请求里带
Cache-Control:普通刷新带max-age=0,强制刷新带no-cache,用来绕过本地缓存拿最新数据。
HTTP 缓存的规则不少,但核心思想很朴素:服务器没通知有变化,就当作没变化;性能最好的请求,是那个压根没被发出去的请求。
面试速答模板
HTTP 缓存主要靠
Cache-Control控制,它在请求和响应里都能用。服务器在响应里用max-age指定资源的新鲜期,起算点是响应生成的时刻,也就是Date头,传输耗时也算在内。另外还有no-store表示完全不缓存,no-cache表示可以缓存但每次使用前都必须向服务器验证,must-revalidate表示过期后必须验证才能再用。缓存过期或者遇到no-cache时,浏览器会发条件请求:用If-Modified-Since带上之前的Last-Modified,或用If-None-Match带上之前的ETag。资源没变,服务器回 304、不带正文,浏览器刷新有效期后继续用缓存;变了就直接回 200 和新内容。ETag 比修改时间更精确,能解决一秒内多次修改、内容没变但时间变了这两种问题,分为逐字节一致的强 ETag 和带W/前缀、语义一致即可的弱 ETag。浏览器这边,普通刷新会发max-age=0并带上校验头,强制刷新发no-cache且不带校验头。工程上常用的组合是:带哈希的静态资源用max-age=31536000, immutable长期缓存,入口 HTML 用no-cache保证每次拿到新版本。