HTTP 报文的结构
核心要点
- 整体是「头 + 身」:一条 HTTP/1.1 报文依次是起始行、若干头字段、一个空行、可选的正文。前两块合起来叫 header,正文叫 body(也叫 entity,实体)。
- header 必须有,body 可以没有:头部结束处一定要跟一个空行,也就是单独的 CRLF(字节
0D 0A)。解析器正是靠这个空行判断「头读完了」。 - 请求的起始行叫请求行:
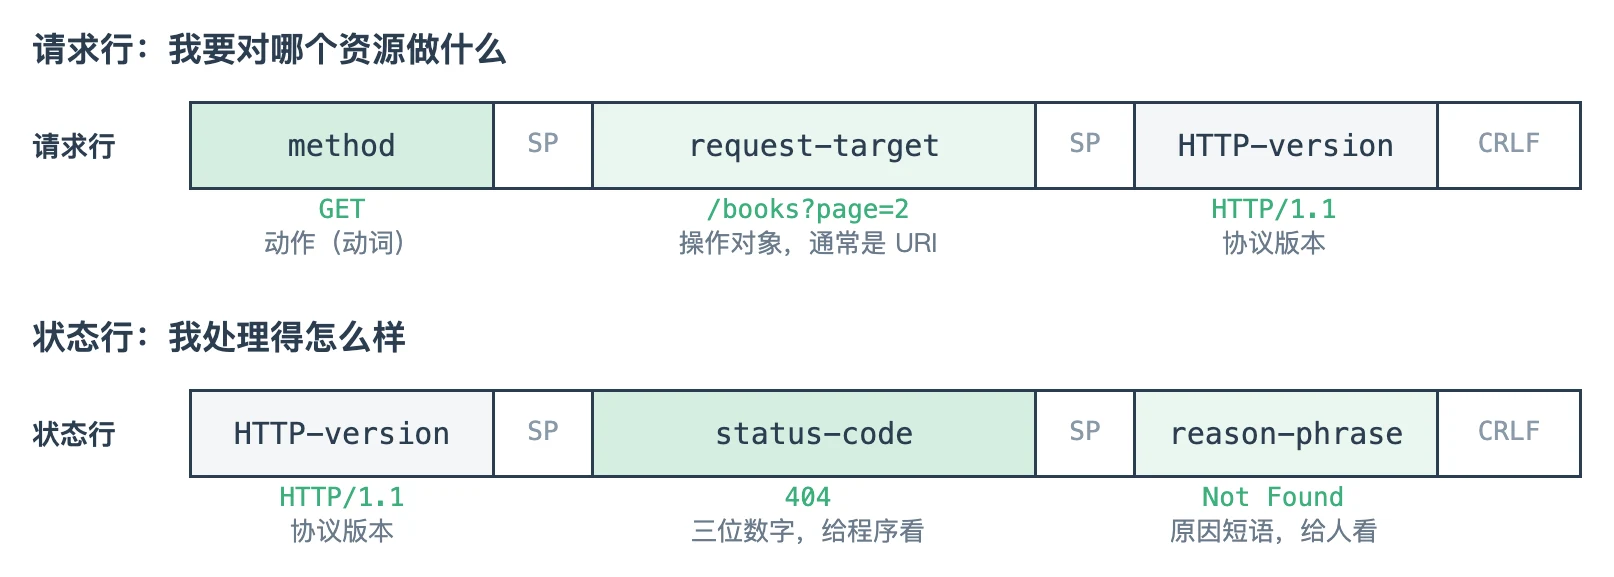
方法 请求目标 版本,例如GET /books?page=2 HTTP/1.1,三段之间用一个空格隔开,行尾 CRLF。 - 响应的起始行叫状态行:
版本 状态码 原因短语,例如HTTP/1.1 404 Not Found。 - 头字段的格式是
名字: 值:名字大小写不敏感、不能含空格、和冒号之间不能有空白;字段顺序不影响语义;一般不应重复,可重复的是列表型字段和Set-Cookie这类特例;还可以自定义字段来扩展协议。 - HTTP/1.1 请求里唯一强制的头是
Host,用来指明要访问的虚拟主机,缺了服务器应当返回 400。 - 头部大小协议不设上限,但服务器会设,例如 Nginx 默认按 1K / 8K 的缓冲区来容纳请求头,超了就报错。
- 明文只是 HTTP/1.1 的特点:HTTP/2、HTTP/3 改用二进制帧,header / body 的逻辑划分保留,但抓包看到的不再是可读文本。
先从 TCP 的包说起
网络协议几乎都有同一种套路:真正要送的数据前面,加一段「说明书」。
以 TCP 为例,每个报文段前面有一个至少 20 字节的固定头部,记录源端口、目的端口、序号、确认号、标志位、窗口大小等信息。数据跟在头部后面;在常见的以太网环境下(MTU 1500,减去 IP 头和 TCP 头各 20 字节),一个报文段能装的数据通常不超过 1460 字节。接收方先读头部,弄清这段数据该交给哪个端口、排在第几位,再把头部剥掉,把数据往上交。
HTTP 也是先说明、后数据,区别在于说明的写法:
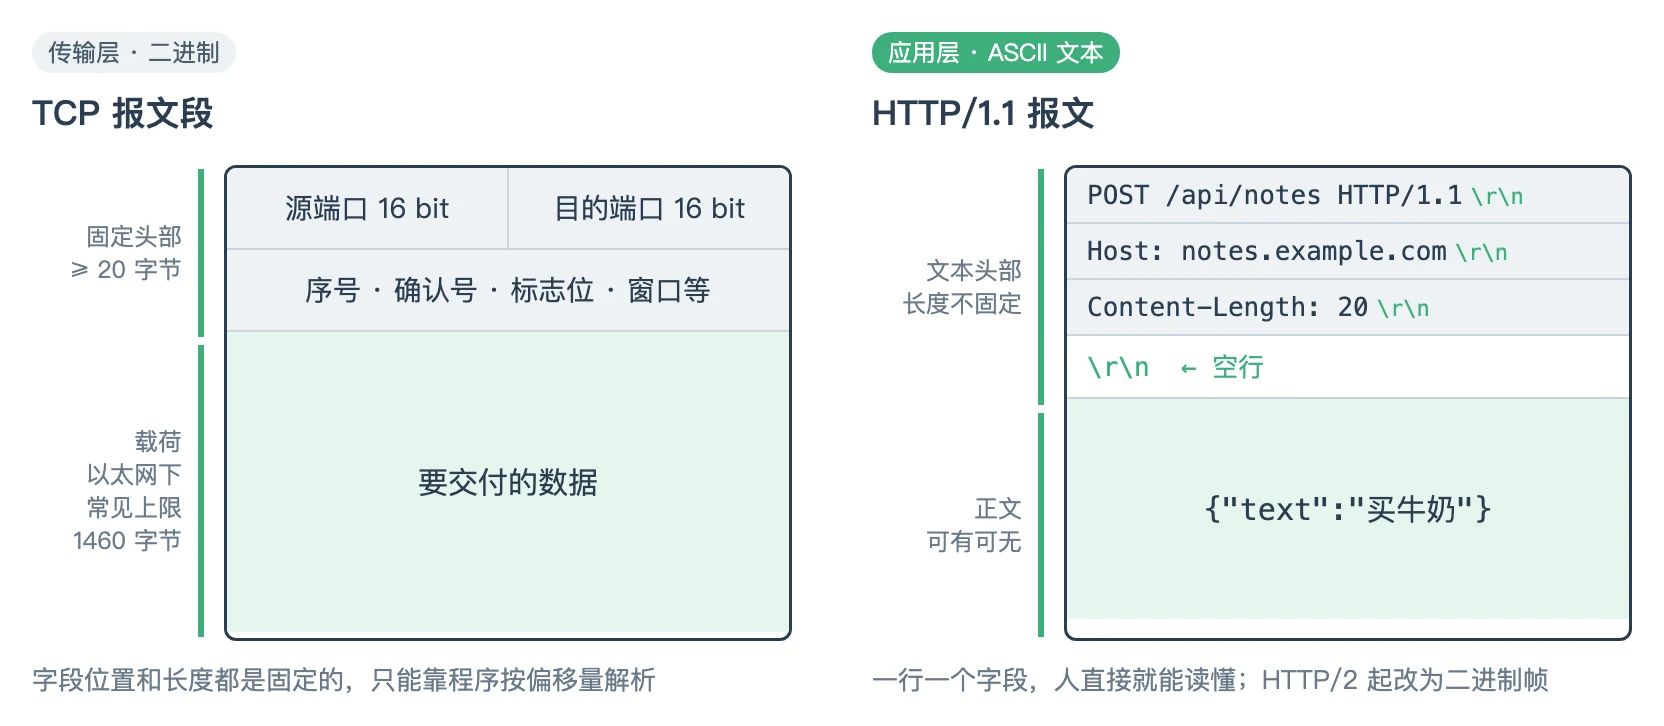
TCP 头部是二进制,每个字段在哪个偏移、占几位都写死了,只能交给程序按位解析。HTTP/1.1 的头部是 ASCII 文本,一行一个字段,就算不用任何工具,把抓到的字节打印出来也能直接看懂。这种「人能读」的特性,是 HTTP 早期容易调试、容易普及的重要原因。
这个结论要加一个限定:它只对 HTTP/1.x 成立。HTTP/2 在 TCP 之上加了一层二进制分帧(Binary Framing Layer),头部被编码进 HEADERS 帧(还会用 HPACK 压缩),正文放在 DATA 帧里;HTTP/3 跑在基于 UDP 的 QUIC 上,同样是二进制帧,头部压缩换成 QPACK。抓包看到的已经是二进制,但「先头后身」这个逻辑模型一点没变,开发者在浏览器 DevTools 里看到的依然是一组头字段加一个正文。
报文由哪几部分组成
请求和响应的骨架完全相同,从上到下依次是:
| 部分 | 英文 | 内容 |
|---|---|---|
| 起始行 | start line | 一句话概括这条报文:请求里写「做什么、对谁做」,响应里写「结果如何」 |
| 头部字段 | header fields | 若干行 名字: 值,补充各种细节,比如内容类型、长度、缓存策略 |
| 空行 | CRLF | 只有 \r\n 两个字节,宣告头部结束 |
| 正文 | body / entity | 真正要传的数据,可以是 HTML、JSON,也可以是图片、视频等二进制内容 |
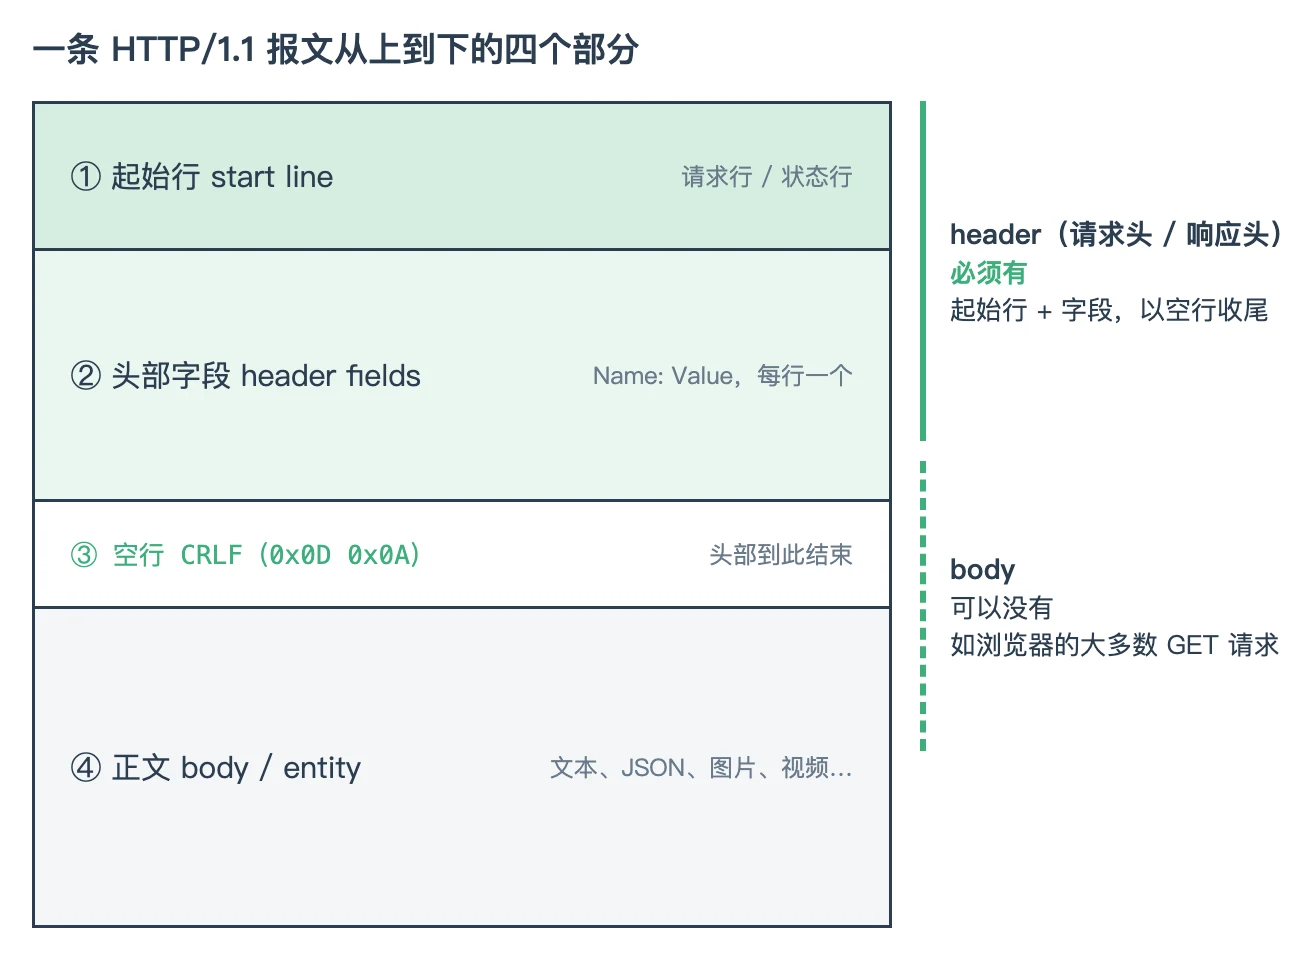
几个叫法要分清:
- 起始行加上头部字段,统称为 header;在请求里叫「请求头」,在响应里叫「响应头」。
- 正文在规范里曾被称作「实体(entity)」,但日常交流里大家更习惯和 header 对着叫,直接说 body。
协议对这几块的要求并不对等:
- header 是必需的,一条报文不可能只有正文。
- body 是可选的,有没有、多长,由
Content-Length或Transfer-Encoding: chunked之类的头字段说明。 - 空行不能省。哪怕后面没有 body,头部最后也必须多一个 CRLF。如果漏了,服务器会一直等下去,以为头部还没发完。
可以把报文想象成一个快递:header 是贴在箱子外面的面单,写着寄给谁、怎么处理、里面是什么;空行是面单和箱子的分界;body 是箱子里的货。面单永远得有,箱子却可以是空的,比如只是去「问一下」的请求。
用十六进制看一眼空行
空行在文本编辑器里看不出来,用字节看就一目了然。下面把一个最小的请求交给 xxd:
printf 'GET / HTTP/1.1\r\nHost: a\r\n\r\n' | xxd
00000000: 4745 5420 2f20 4854 5450 2f31 2e31 0d0a  GET / HTTP/1.1..
00000010: 486f 7374 3a20 610d 0a0d 0a              Host: a....
每一行以 0d 0a 结束,而末尾连续出现的 0d 0a 0d 0a 就是「最后一个字段的行尾 + 空行」。服务端解析请求时,找的就是这四个字节。
实际抓到的请求长什么样
在浏览器地址栏输入一个网址回车,浏览器发出的请求把每个字节还原出来,大致如下(为了排版,User-Agent 和 Accept 做了缩写):
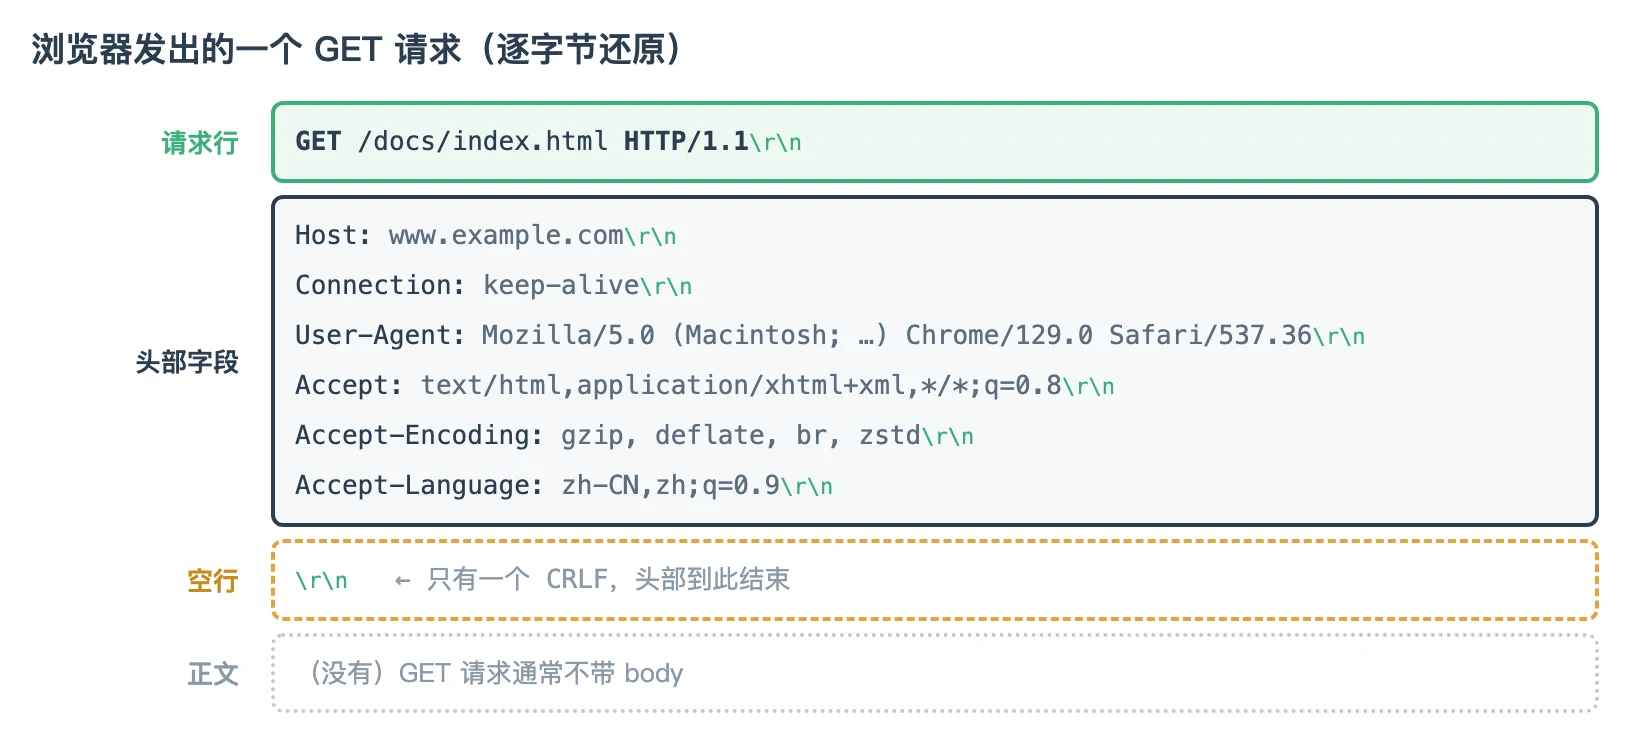
对照上面的结构:
- 第一行
GET /docs/index.html HTTP/1.1是请求行; Host、Connection、User-Agent、Accept等每一行都是一个头字段;- 最后是一个空行,然后报文就结束了,没有 body。
浏览器发出的 GET 请求绝大多数都是这样:只有头、没有身。互联网上每时每刻流动的请求里,这种「只有面单」的报文占了大头。
头部虽然可以写很多行,但也不能无限膨胀。HTTP 规范本身没给 header 规定大小上限,可每个 Web 服务器都会自己设一个,因为解析和缓存一个巨大的请求头会消耗内存和 CPU,也容易被拿来做攻击。以 Nginx 为例:默认先用 1K 的 client_header_buffer_size 接收请求头,放不下再启用 large_client_header_buffers(默认 4 个 8K),单个请求行或单个头字段超过 8K 就会被拒绝,可以通过调整 large_client_header_buffers 来放宽。Cookie 过多是现实中最常撞到这条限制的原因。
请求行:做什么、对谁做
请求报文的起始行叫请求行(request line),用一句话告诉服务器:客户端打算对哪个资源执行什么操作。它由三段组成:
- 请求方法(method):一个动词,比如
GET、POST、PUT、DELETE,代表对资源的动作。 - 请求目标(request-target):动作的对象,一般是 URI 的路径加查询部分,比如
/books?page=2。 - 协议版本(HTTP-version):本条报文按哪个版本的 HTTP 来写,比如
HTTP/1.1。
三段之间用空格(SP)分隔,行尾用 CRLF 结束。
请求目标并不总是一个路径,还有几种特殊形式,面试偶尔会问到:
| 形式 | 示例 | 用在哪 |
|---|---|---|
| origin-form | GET /books?page=2 HTTP/1.1 | 最常见,直接发给源服务器 |
| absolute-form | GET http://shop.example.com/books HTTP/1.1 | 发给正向代理时写完整 URL |
| authority-form | CONNECT shop.example.com:443 HTTP/1.1 | CONNECT 方法建立隧道 |
| asterisk-form | OPTIONS * HTTP/1.1 | 询问服务器整体能力,不针对具体资源 |
状态行:结果怎么样
响应报文的起始行叫状态行(status line),比请求行更简单,同样是三段:
- 协议版本:响应所用的 HTTP 版本。
- 状态码(status code):三位数字,程序靠它判断结果,例如
200表示成功、404表示资源不存在、500表示服务器内部出错。 - 原因短语(reason phrase):对状态码的文字解释,例如
OK、Not Found,主要是给人看的。
原因短语只是一种辅助说明,客户端不应该依赖它做判断,同一个 200 写成 200 Success 也完全合法。HTTP/2 和 HTTP/3 干脆把它去掉了,只保留一个 :status 伪头字段来携带状态码。
头字段:报文的「说明书」
起始行后面跟上一组头字段,就构成了完整的请求头或响应头:
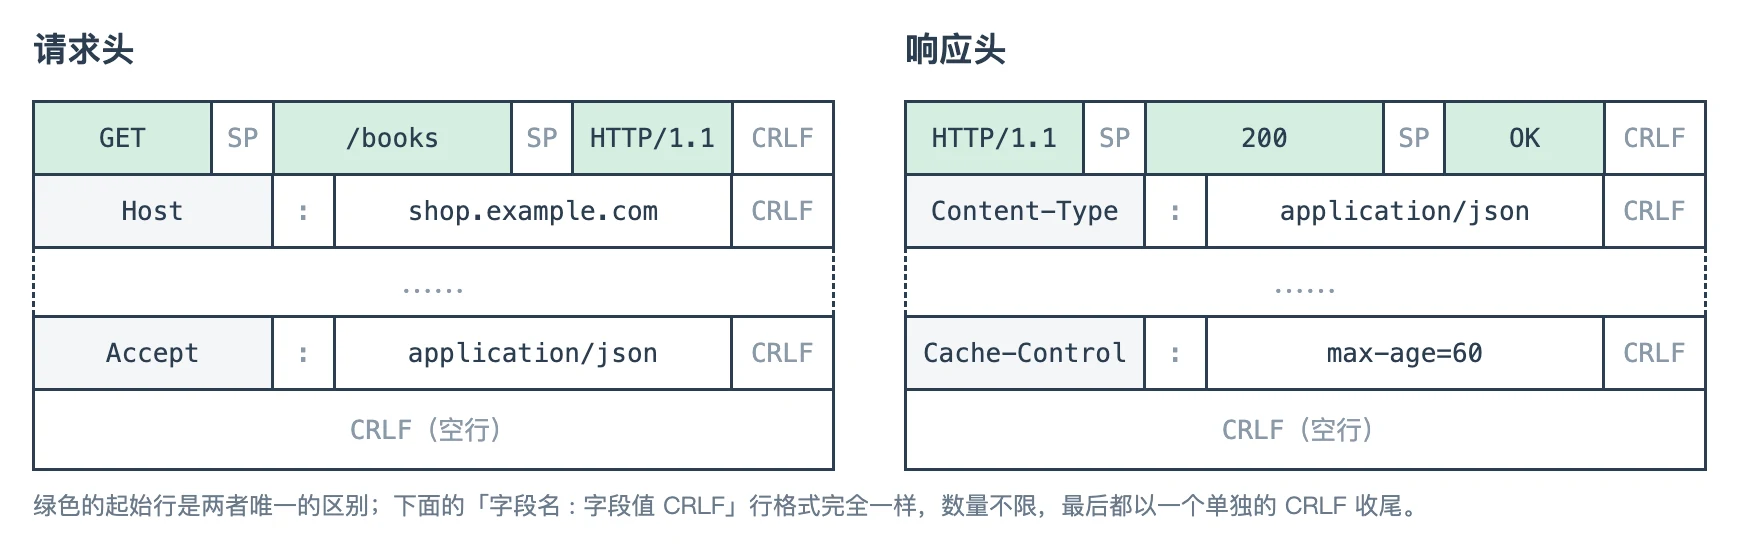
两者唯一的差别就是第一行,后面的字段行格式完全一致,所以请求头字段和响应头字段可以放在一起讲。
格式
每个字段占一行,冒号左边是字段名,右边是字段值,行尾 CRLF。例如 Host: shop.example.com 这一行,字段名是 Host,字段值是 shop.example.com。
字段并不局限于标准里定义好的那些(Host、Content-Type、Cache-Control ……),双方可以自行约定新字段,比如在请求里加 X-Trace-Id 做链路追踪、在响应里加 X-Request-Id 方便排查日志。HTTP 能长期扩展出缓存、Cookie、跨域、内容协商等各种能力,靠的正是这种「随时可以多加一行」的设计。
自定义字段过去习惯加
X-前缀,RFC 6648 已经不再推荐这么做,新设计的字段直接起一个有意义的名字即可。但已经广泛使用的X-Forwarded-For、X-Powered-By等不会改名。
使用规则
| 规则 | 说明 | 例子 |
|---|---|---|
| 名字不区分大小写 | 解析器一律忽略大小写;首字母大写只是可读性更好的惯例。HTTP/2 和 HTTP/3 更进一步,要求字段名在传输时必须全小写 | Content-Type 与 content-type 等价 |
| 名字里不能有空格 | 多个单词用连字符 - 连接 | User-Agent 合法,User Agent 不合法 |
| 下划线最好别用 | 规范的字符集其实允许 _,但 Nginx 默认会丢弃带下划线的字段(underscores_in_headers 默认 off),部分网关也会拦截,实际开发中等同于「不能用」 | 用 api-version,别用 api_version |
| 名字与冒号紧挨着 | 冒号前出现空白必须被拒绝,服务器应返回 400;冒号后面、值的前后可以有空白,解析时会被去掉 | Host: a 合法,Host : a 会被拒 |
| 顺序无关 | 字段先写哪个后写哪个都不改变含义 | Host 放第一行或最后一行都行 |
| 原则上不重复 | 只有值本身是逗号分隔列表的字段才可以出现多次,接收方会把它们按顺序合并成一个列表;Set-Cookie 是特例,不能合并,必须分多行发送 | 一个响应里有多个 Set-Cookie 行很常见 |
另外两个细节:
- 请求行里的分隔符:标准写法是单个空格。规范允许接收方宽松一点,把制表符等空白也当作分隔符来解析,但发送方应当只用一个空格,不要依赖这种宽容。
- 字段不能折行:早期允许一个字段值换行后以空格或制表符开头接着写(obs-fold,行折叠),RFC 7230 起已经废弃,现在每个字段必须完整写在一行里。
最重要的那个字段:Host
HTTP/1.1 规定请求里必须带 Host 字段,这是唯一一个强制要求的头。原因是一台服务器(同一个 IP 和端口)上往往托管着很多个网站,即虚拟主机。请求行里只有路径 /docs/index.html,没有域名,服务器只能靠 Host 判断这次请求是给哪个站点的。
缺少 Host 的 HTTP/1.1 请求,以及出现多个 Host 字段的请求,服务器都应该回 400 Bad Request。HTTP/2 和 HTTP/3 里,这个角色由 :authority 伪头字段承担。
顺带认识两个响应头
响应里的 Server 字段说明服务端用的是什么软件,比如 Server: nginx/1.25.3。和它很像的还有一个非标准的 X-Powered-By,表示后端用的语言或框架,比如 X-Powered-By: PHP/8.2.12 或 X-Powered-By: Express。这两个字段会把技术栈和版本号暴露给攻击者,生产环境通常会隐藏版本号或干脆去掉,例如 Nginx 配置 server_tokens off;,Express 调用 app.disable('x-powered-by')。
动手:不用 http 模块收发一次报文
既然 HTTP/1.1 就是文本,那么只用 TCP 套接字也能「手写」一个服务器。下面的脚本用 Node 的 net 模块直接读写字节流:找到 \r\n\r\n 就切出头部,再按行拆出请求行和头字段,最后拼一段响应文本发回去;客户端用内置的 fetch,它并不知道对面不是一个正经的 HTTP 服务器。
// raw-http.mjs —— 运行:node raw-http.mjs(Node 18+)
import net from 'node:net';

const server = net.createServer((socket) => {
  let buffer = '';
  socket.on('data', (chunk) => {
    buffer += chunk.toString('latin1');
    const end = buffer.indexOf('\r\n\r\n');          // 空行 = 头部结束
    if (end === -1) return;                          // 头部还没收全

    const head = buffer.slice(0, end);
    const [requestLine, ...fieldLines] = head.split('\r\n');
    const [method, target, version] = requestLine.split(' ');
    console.log('请求行 ->', { method, target, version });

    const fields = {};
    for (const line of fieldLines) {
      const colon = line.indexOf(':');
      const name = line.slice(0, colon).toLowerCase(); // 字段名不区分大小写
      fields[name] = line.slice(colon + 1).trim();     // 值两侧的空白可以去掉
    }
    console.log('头字段 ->', fields);

    const payload = JSON.stringify({ ok: true, path: target });
    socket.end(
      'HTTP/1.1 200 OK\r\n' +
      'Content-Type: application/json\r\n' +
      `Content-Length: ${Buffer.byteLength(payload)}\r\n` +
      'X-Demo-Server: raw-net\r\n' +
      '\r\n' +
      payload
    );
  });
});

server.listen(0, async () => {
  const { port } = server.address();
  const res = await fetch(`http://127.0.0.1:${port}/books?page=2`, {
    headers: { 'X-Trace-Id': 'abc123' },
  });
  console.log('状态 ->', res.status, res.statusText);
  console.log('响应头 x-demo-server ->', res.headers.get('x-demo-server'));
  console.log('正文 ->', await res.text());
  server.close();
});
在 Node 26 上的输出(端口每次随机):
请求行 -> { method: 'GET', target: '/books?page=2', version: 'HTTP/1.1' }
头字段 -> {
  host: '127.0.0.1:60634',
  connection: 'keep-alive',
  'x-trace-id': 'abc123',
  accept: '*/*',
  'accept-language': '*',
  'sec-fetch-mode': 'cors',
  'user-agent': 'node',
  'accept-encoding': 'gzip, deflate'
}
状态 -> 200 OK
响应头 x-demo-server -> raw-net
正文 -> {"ok":true,"path":"/books?page=2"}
可以看到:fetch 自动带上了 Host;自定义的 X-Trace-Id 原样到达;我们手写的状态行、头字段、空行、正文,被客户端正确识别成了状态码、响应头和 body。这个示例为了演示做了简化,比如假设一个请求只来一次、不处理 body,真实服务器还要处理分块传输、持久连接、各种非法输入。
再验证几条头字段规则
Node 自带的 http 模块解析很严格,可以拿它验证上面表格里的规则:
// strict-check.mjs —— 运行:node strict-check.mjs
import http from 'node:http';
import net from 'node:net';

const server = http.createServer((req, res) => res.end('ok\n'));

// 发一段手写的原始请求,只看响应的状态行
function probe(label, raw, port) {
  return new Promise((resolve) => {
    const sock = net.connect(port, '127.0.0.1', () => sock.write(raw));
    let got = '';
    sock.on('data', (d) => (got += d));
    sock.on('close', () => {
      console.log(label.padEnd(18), '=>', got.split('\r\n')[0]);
      resolve();
    });
  });
}

server.listen(0, async () => {
  const { port } = server.address();
  const C = 'Connection: close\r\n';
  await probe('正常请求', `GET /a HTTP/1.1\r\nHost: x\r\n${C}\r\n`, port);
  await probe('缺少 Host', `GET /a HTTP/1.1\r\n${C}\r\n`, port);
  await probe('冒号前有空格', `GET /a HTTP/1.1\r\nHost : x\r\n${C}\r\n`, port);
  await probe('字段名小写', `GET /a HTTP/1.1\r\nhOsT: x\r\n${C}\r\n`, port);
  server.close();
});
正常请求               => HTTP/1.1 200 OK
缺少 Host            => HTTP/1.1 400 Bad Request
冒号前有空格             => HTTP/1.1 400 Bad Request
字段名小写              => HTTP/1.1 200 OK
缺 Host、冒号前带空格都被直接拒成 400,而大小写混乱的 hOsT 照样能用。
面试速答模板
HTTP 报文分 header 和 body 两大块。header 由起始行和若干头字段组成,结尾必须跟一个空行(CRLF,
0D 0A);body 是可选的,像浏览器的 GET 请求通常就只有 header。请求的起始行叫请求行,格式是「方法 请求目标 版本」,比如GET /index.html HTTP/1.1;响应的起始行叫状态行,格式是「版本 状态码 原因短语」,比如HTTP/1.1 200 OK,三段都用空格隔开、以 CRLF 结尾。头字段是名字: 值的形式,名字不区分大小写、不能含空格,冒号前不能有空白,字段顺序无关,一般不能重复(列表型字段和Set-Cookie除外),也可以自定义字段扩展功能。HTTP/1.1 唯一强制的请求头是Host,因为同一台服务器可能托管多个虚拟主机。协议不限制头部大小,但服务器会限制,比如 Nginx 单行默认 8K。最后,明文格式是 HTTP/1.1 的特点,HTTP/2、HTTP/3 改成了二进制帧,但 header / body 的逻辑结构不变。